KaggleのテーブルデータでDNNを利用してみた
DNN(ディープニューラルネットワーク:Deep Neural Network)とは、人間の脳の神経回路を模した人工ニューラルネットワークを多層化し、複雑なデータから高精度な特徴を自動で学習する深層学習(ディープラーニング)の中心的な技術である。
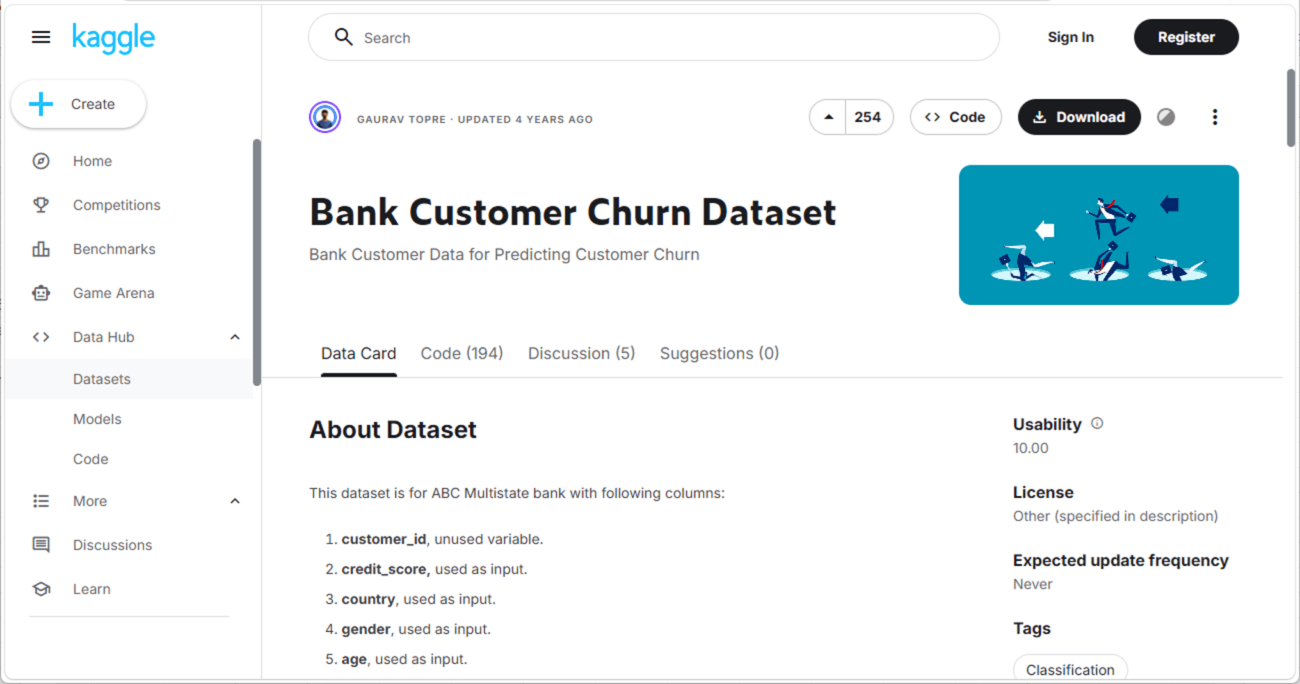
今回は、Kaggleのテーブルデータセット「Bank Customer Churn Dataset」でDNNを利用してみたので、その手順を共有する。
なお、DNNについては、以下のサイトを参照のこと。
https://biz.kddi.com/content/column/smartwork/what-is-dnn/
前提条件
下記記事のKaggleのアカウント登録が完了していること。
また、Kaggleの下記「Bank Customer Churn Dataset」でコード実行できる状態になっていること。
やってみたこと
データの読み込みと確認
「Bank Customer Churn Dataset」で、訓練データを読み込みデータを確認する実装例は、以下の通り。
1) 以下のようにライブラリを読み込み、inputファイル名を確認する。
# ライブラリを読み込む
import numpy as np
import pandas as pd
import os
# ファイル名を一覧表示する
for dirname, _, filenames in os.walk('/kaggle/input'):
    for filename in filenames:
        print(os.path.join(dirname, filename))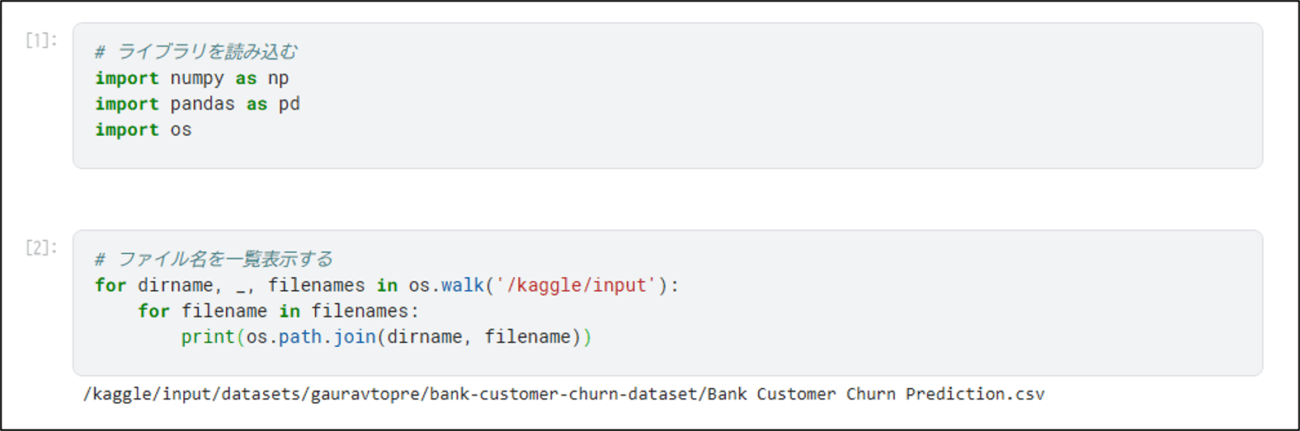
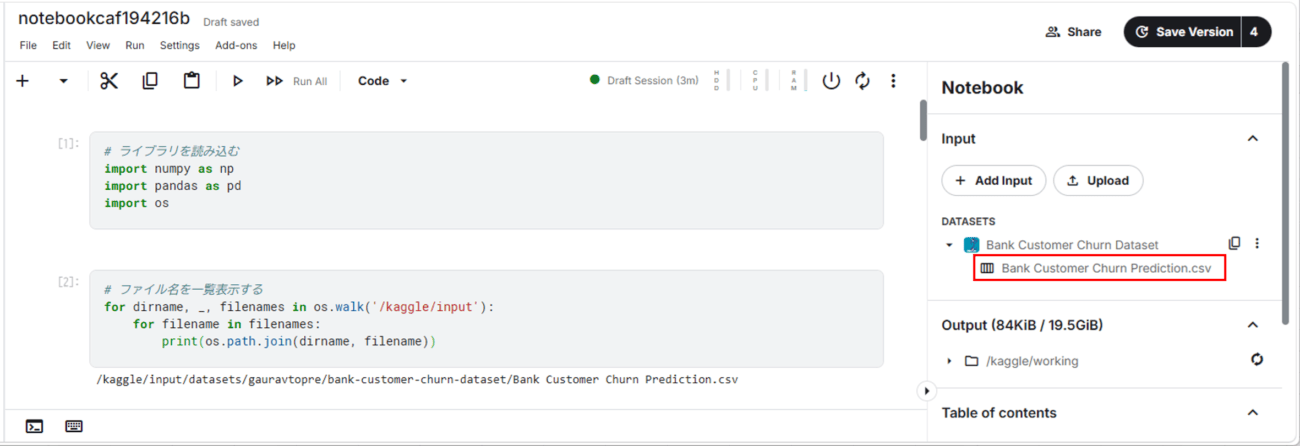
実際、以下のように、インプットファイルが配置されているのが確認できる。
2) インプットファイル「Bank Customer Churn Prediction.csv」を読み込む。
# ファイルを読み込む
df = pd.read_csv('/kaggle/input/datasets/gauravtopre/bank-customer-churn-dataset/Bank Customer Churn Prediction.csv')
print(df.shape)
df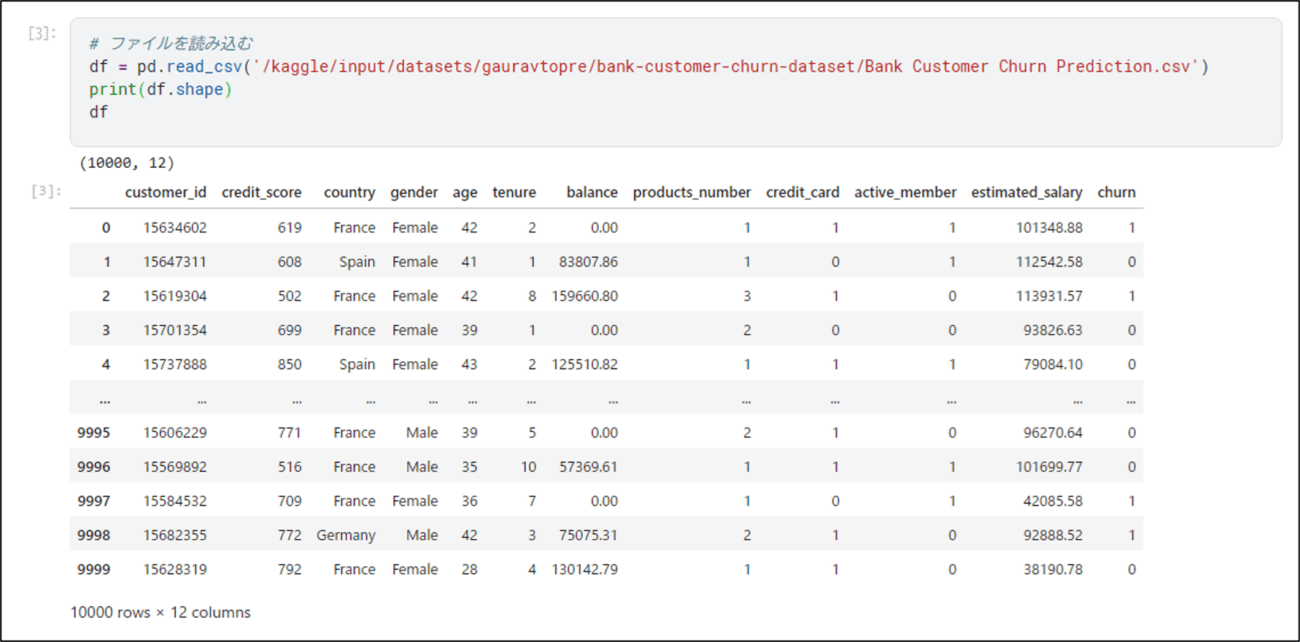
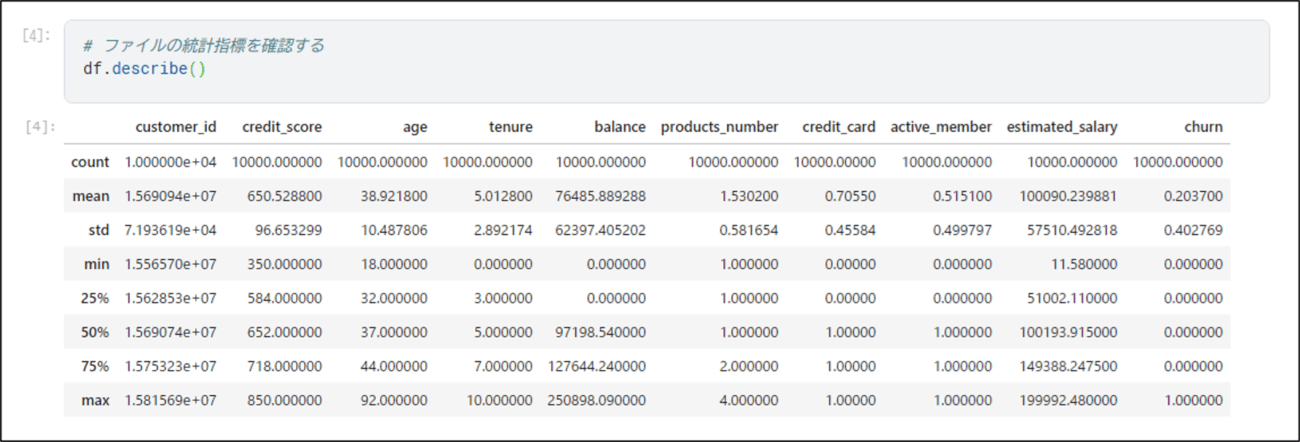
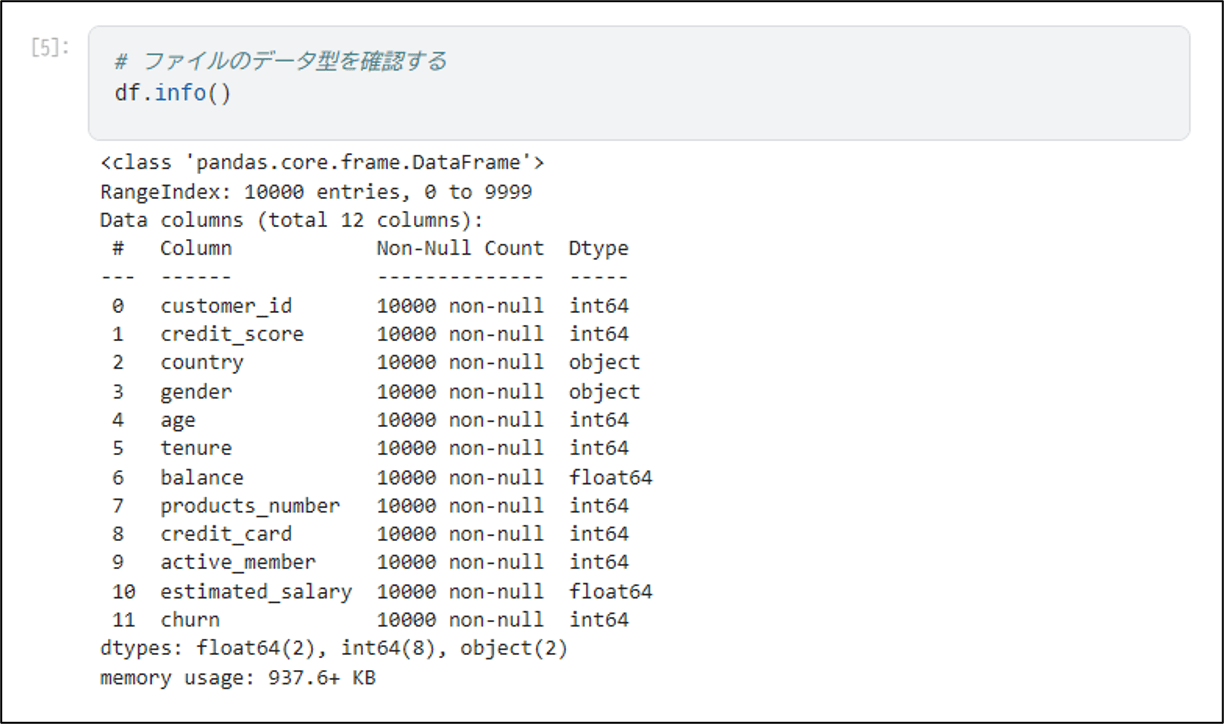
3) 2)で読み込んだファイルの統計情報・データ型を確認する。
# ファイルの統計指標を確認する
df.describe()
# ファイルのデータ型を確認する
df.info()
データの前処理
「Bank Customer Churn Dataset」で、データの前処理を行う実装例は、以下の通り。
1) 読み込んだファイルから、不要な列を削除する。
# 判定に使わないcustomer_idを除外する
df = df.drop('customer_id', axis=1)
print(df.shape)
df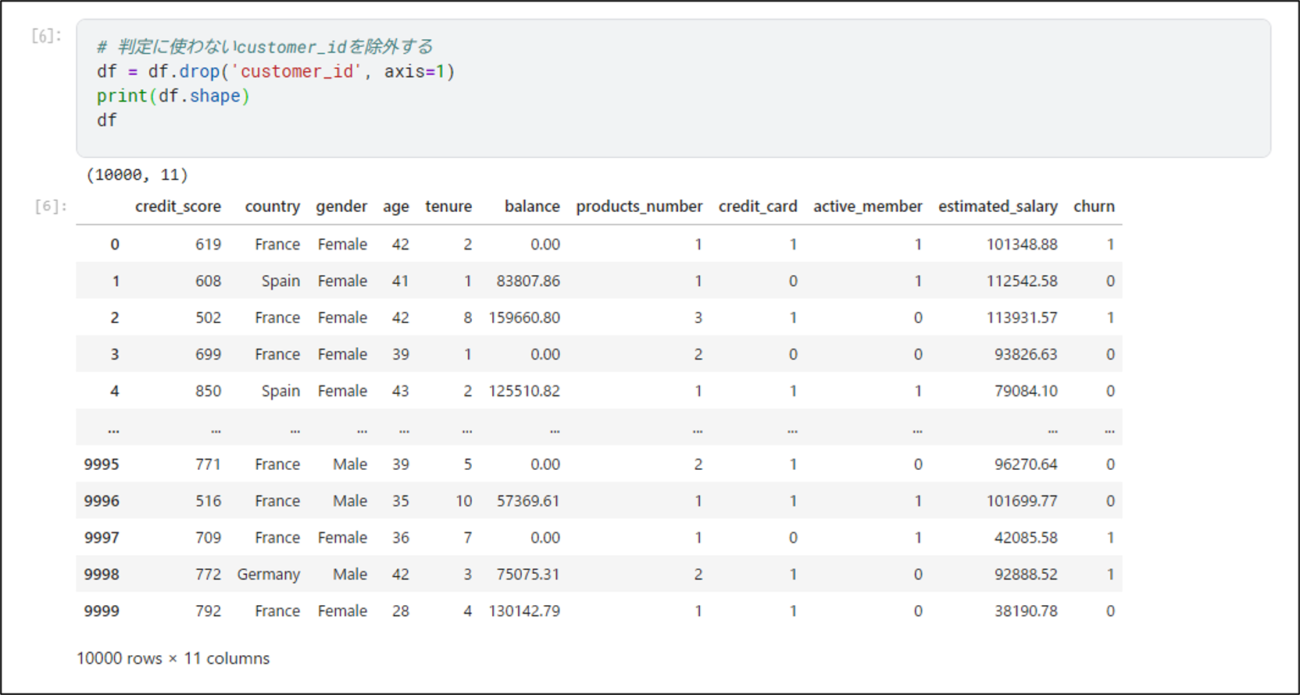
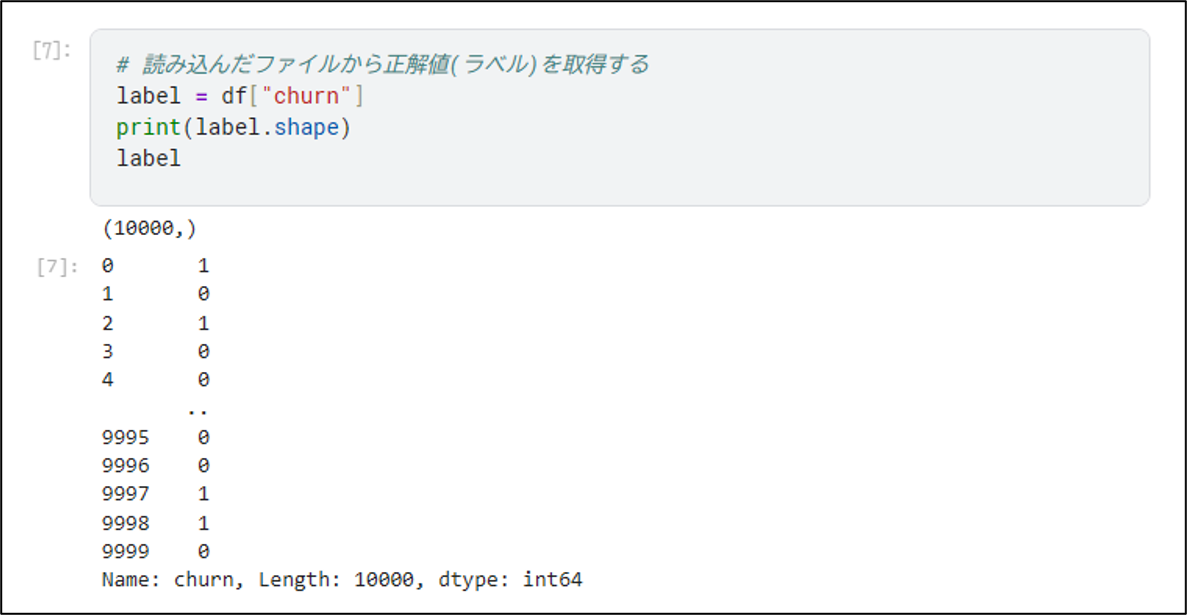
2) 読み込んだファイルから正解値(ラベル)を取得する。
# 読み込んだファイルから正解値(ラベル)を取得する
label = df["churn"]
print(label.shape)
label
3) 読み込んだファイルから正解値(ラベル)を除去した値を、dataに設定する。
# 読み込んだファイルから正解値(ラベル)を除去した値をdataに格納する
data = df.drop("churn", axis=1)
print(data.shape)
data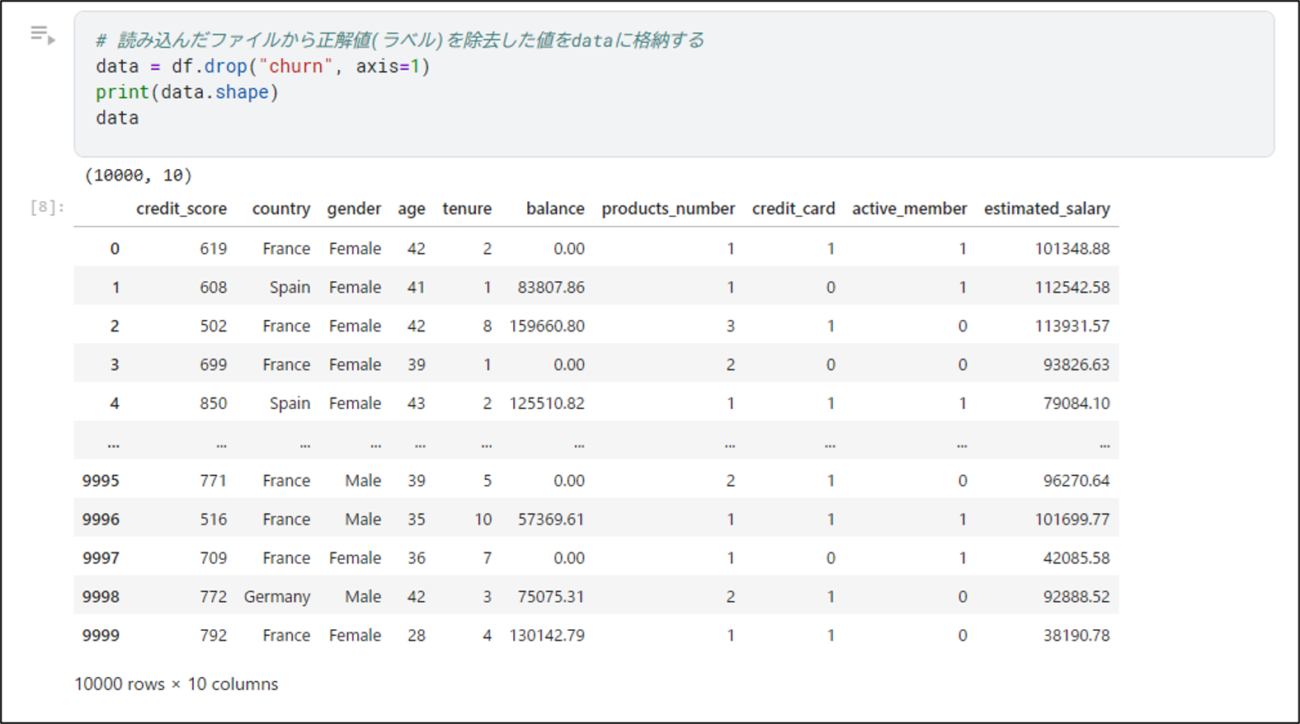
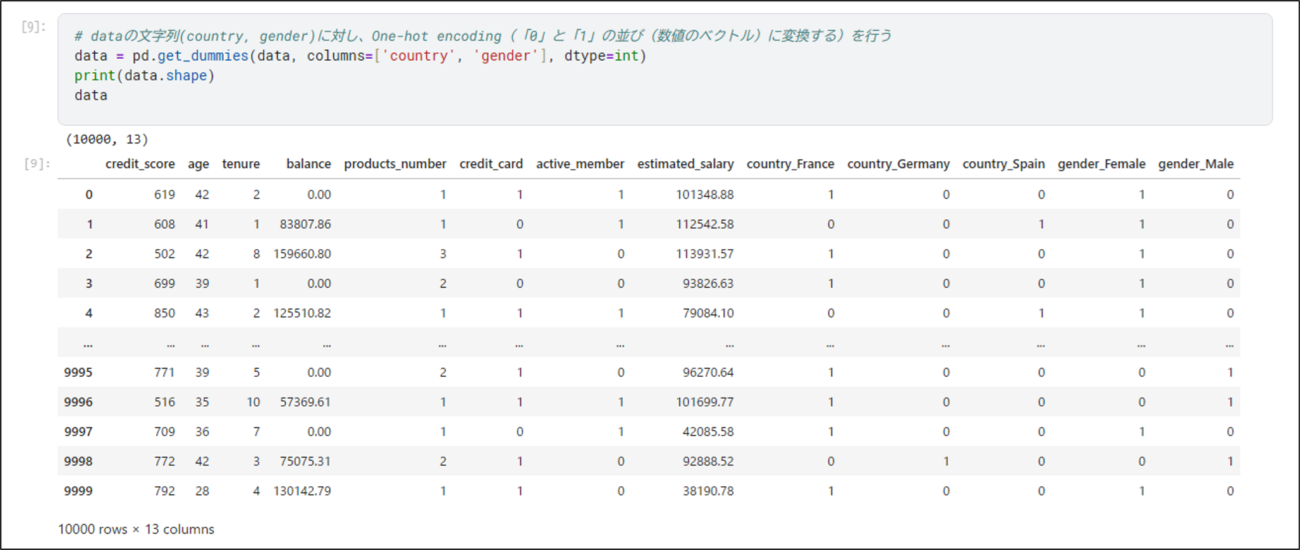
4) 読み込んだファイルのカテゴリカルデータ(文字や分類のデータ)をOne-hot encoding(「0」と「1」の並び(数値のベクトル)に変換する)を行う。
# dataの文字列(country, gender)に対し、One-hot encoding(「0」と「1」の並び(数値のベクトル)に変換する)を行う
data = pd.get_dummies(data, columns=['country', 'gender'], dtype=int)
print(data.shape)
data
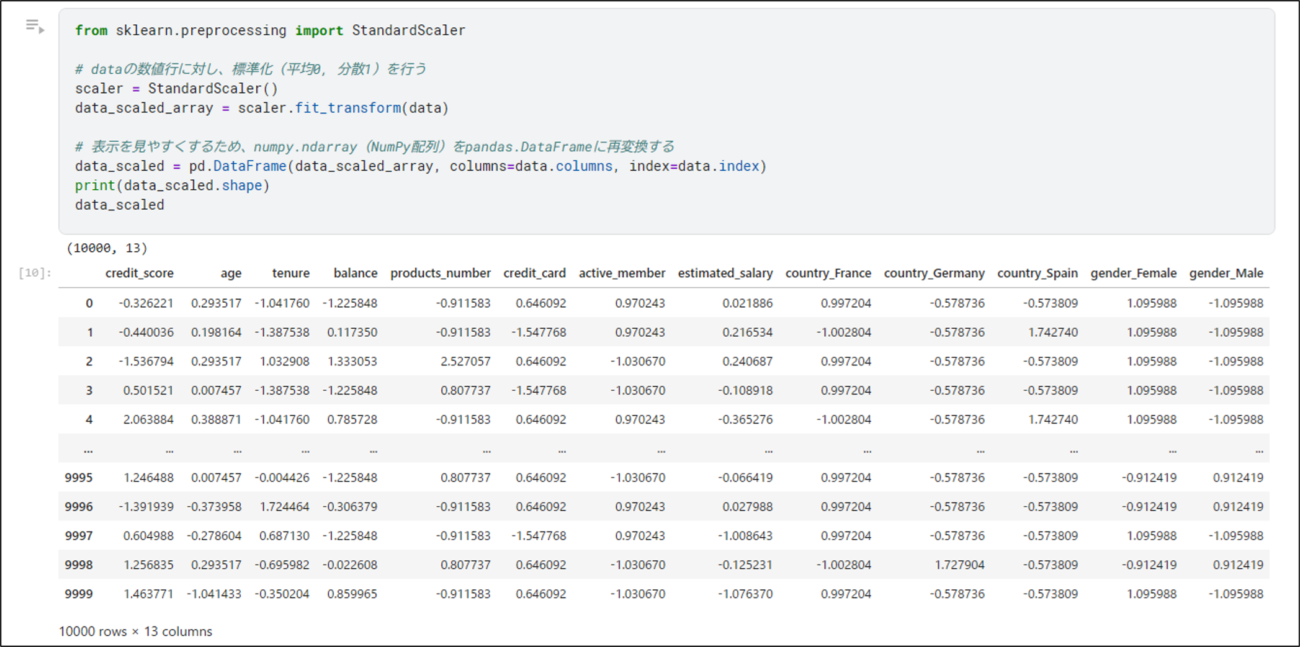
5) 読み込んだファイルの数値データを標準化する。
from sklearn.preprocessing import StandardScaler

# dataの数値行に対し、標準化(平均0, 分散1)を行う
scaler = StandardScaler()
data_scaled_array = scaler.fit_transform(data)

# 表示を見やすくするため、numpy.ndarray(NumPy配列)をpandas.DataFrameに再変換する
data_scaled = pd.DataFrame(data_scaled_array, columns=data.columns, index=data.index)
print(data_scaled.shape)
data_scaled
6) 読み込んだデータを、訓練データとテストデータに分割する。
from sklearn.model_selection import train_test_split

# label, dataを訓練データとテストデータに分割する
# random_state : 実行結果を毎回固定するために指定
# stratify : 均等に分割したいデータ
# test_size : テストデータに利用したい割合
train_data, test_data, train_label, test_label = train_test_split(data_scaled, label, random_state=0, stratify=label, test_size=0.2)
print("train_data_shape : " + str(train_data.shape))
print("test_data_shape : " + str(test_data.shape))
print("train_label_shape : " + str(train_label.shape))
print("test_label_shape : " + str(test_label.shape))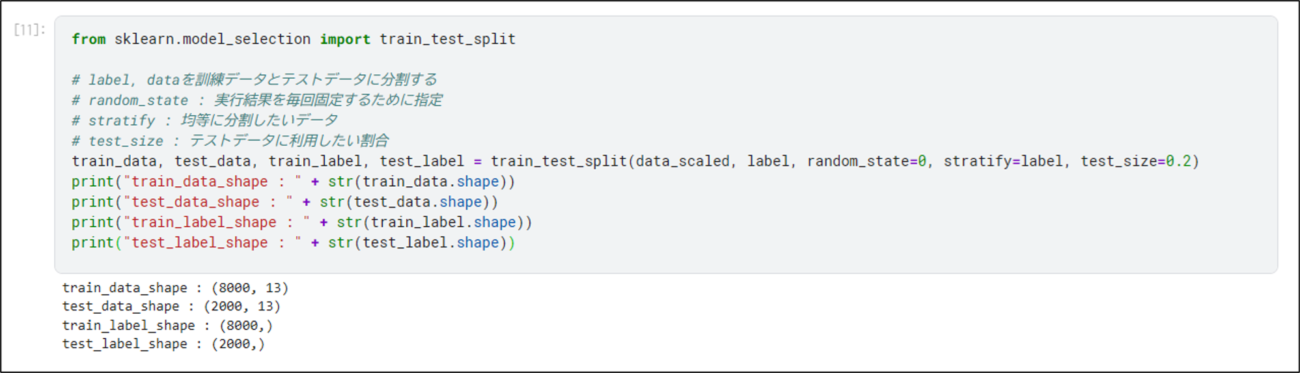
DNNモデルの構築と検証
DNNモデルの構築と検証例は、以下の通り。
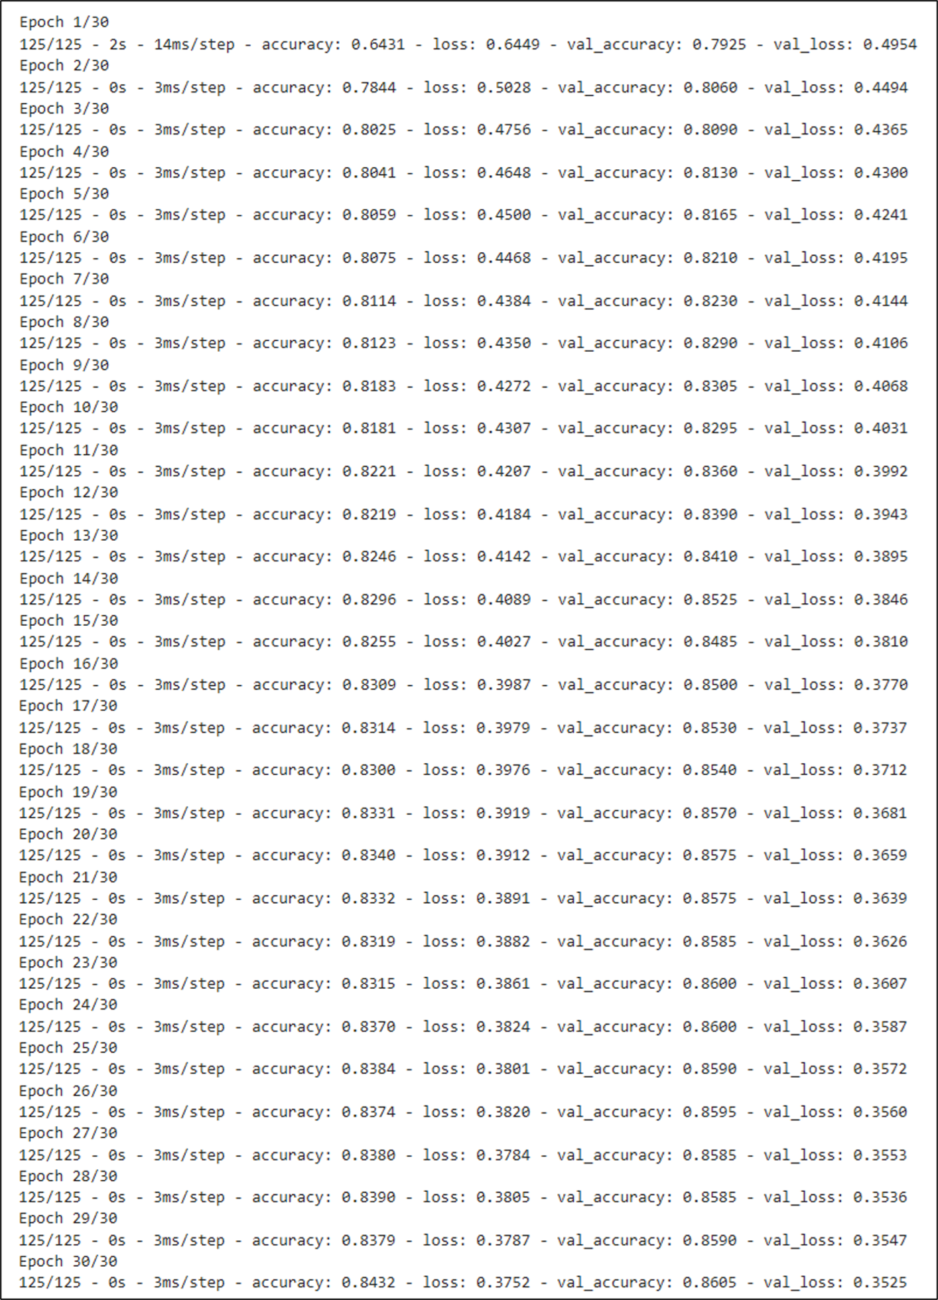
1) Kerasを用いて、DNNモデルを構築し検証する実装例は、以下の通り。
import keras
import tensorflow as tf
from tensorflow.keras import layers, models

# 乱数シードを固定化し、結果の再現性を確保
keras.utils.set_random_seed(0)

# Kerasを用いて、DNNモデルの構築
model = models.Sequential()
# 入力層、shapeには、dataのカラム数=13を指定
model.add(layers.Input(shape=(13,)))
# 中間層、ノード数、活性化関数(ReLU)を指定
# 過学習を防ぐためドロップアウト(Dropout)を設定
model.add(layers.Dense(16, activation='relu'))
model.add(layers.Dropout(0.2))
model.add(layers.Dense(8, activation='relu'))
model.add(layers.Dropout(0.3))
# 出力層
# ノード数は、labelが取り得る値が0か1なので、1を指定
# 活性化関数には、(確率から0~1の値に変換する)シグモイド関数を指定
model.add(layers.Dense(1, activation='sigmoid'))

# モデルのコンパイル
model.compile(
      optimizer='adam'            # 最適化アルゴリズムにAdamを指定
    , loss='binary_crossentropy'  # 損失関数に二値交差エントロピー誤差を指定
    , metrics=['accuracy'])       # 評価関数に正解率を指定

# 学習と予測
history = model.fit(
      train_data    # 使用する訓練データの特徴量
    , train_label   # 使用する訓練データの正解値(ラベル)
    , validation_data=(test_data, test_label) # 使用するテストデータ
    , epochs=30       # エポック数(何回繰り返すか)
    , batch_size=64   # バッチサイズ(1エポックで使用するデータ量)
    , verbose=2       # 学習中の進捗ログの表示スタイル
)
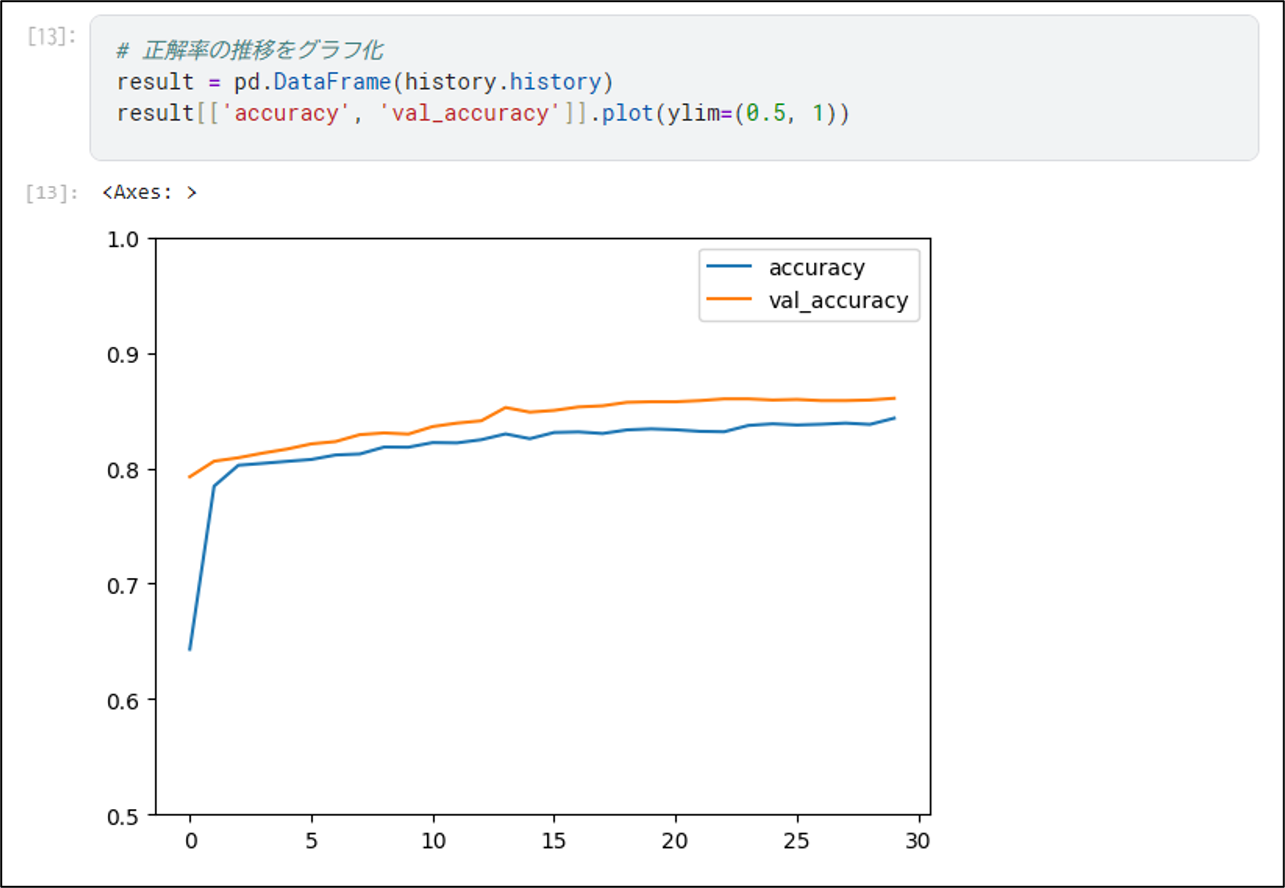
2) 1)の正解率をグラフ化する実装例は、以下の通り。
# 正解率の推移をグラフ化
result = pd.DataFrame(history.history)
result[['accuracy', 'val_accuracy']].plot(ylim=(0.5, 1))
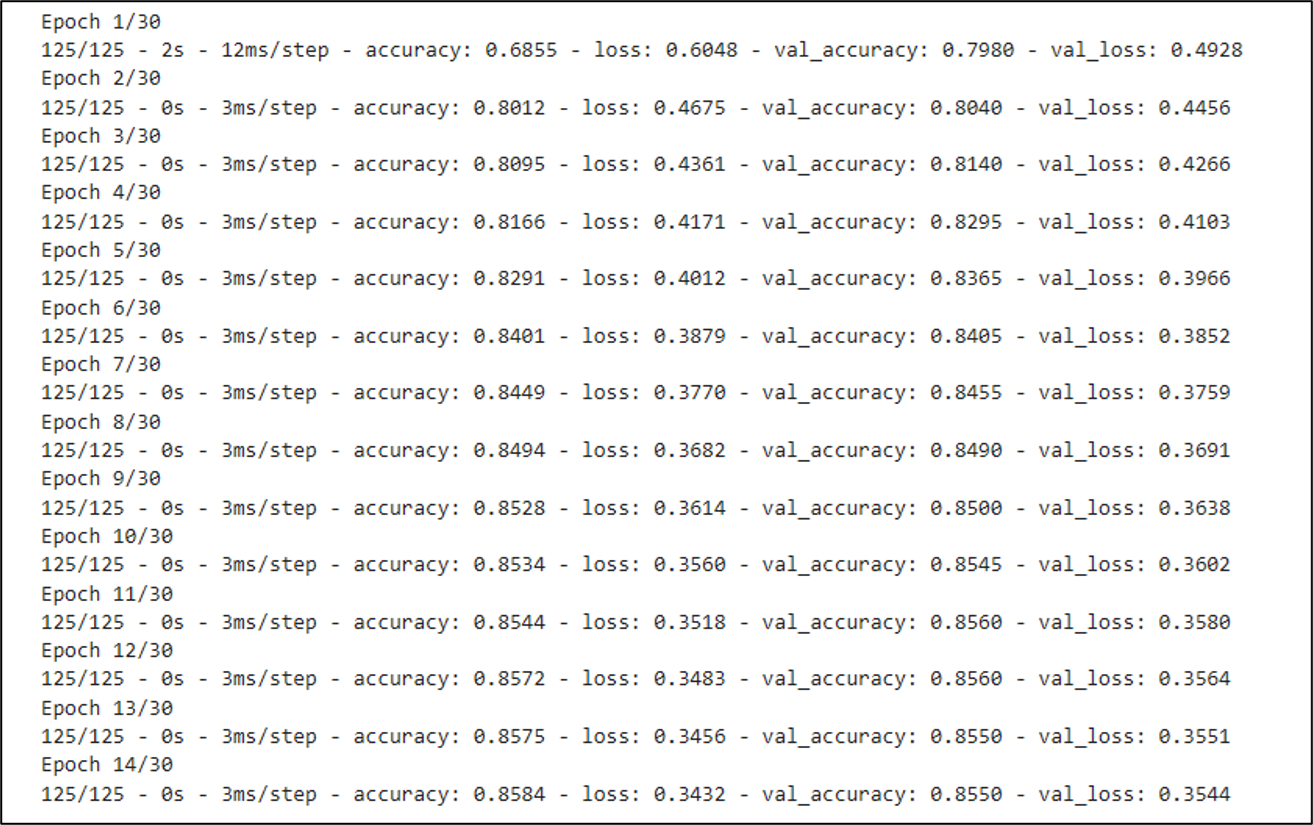
3) Kerasを用いたDNNモデルに、(過学習を防ぐための)早期終了を組み込んだ実装例は以下の通りで、エポック数(30回)に到達する前に学習が打ち切られていることが確認できる。
import keras
import tensorflow as tf
from tensorflow.keras import layers, models

# 乱数シードを固定化し、結果の再現性を確保
keras.utils.set_random_seed(0)

# Kerasを用いて、DNNモデルの構築
model = models.Sequential()
# 入力層、shapeには、dataのカラム数=13を指定
model.add(layers.Input(shape=(13,)))
# 中間層、ノード数、活性化関数(ReLU)を指定
model.add(layers.Dense(16, activation='relu'))
model.add(layers.Dense(8, activation='relu'))
# 出力層
# ノード数は、labelが取り得る値が0か1なので、1を指定
# 活性化関数には、(確率から0~1の値に変換する)シグモイド関数を指定
model.add(layers.Dense(1, activation='sigmoid'))

# モデルのコンパイル
model.compile(
      optimizer='adam'            # 最適化アルゴリズムにAdamを指定
    , loss='binary_crossentropy'  # 損失関数に二値交差エントロピー誤差を指定
    , metrics=['accuracy'])       # 評価関数に正解率を指定

# 過学習を防ぐためのEarly Stopping
early_stopping = tf.keras.callbacks.EarlyStopping(
    monitor='val_accuracy',
    mode='max',                 # 精度は高い方が良いため 'max' を指定
    patience=3,                 # 改善しないエポックの許容回数
    restore_best_weights=True   # 最も性能が良かった重みを復元)
)

# 学習と予測
history = model.fit(
      train_data    # 使用する訓練データの特徴量
    , train_label   # 使用する訓練データの正解値(ラベル)
    , validation_data=(test_data, test_label) # 使用するテストデータ
    , epochs=30       # エポック数(何回繰り返すか)
    , batch_size=64   # バッチサイズ(1エポックで使用するデータ量)
    , callbacks=[early_stopping]  # 過学習を防ぐためのEarly Stoppingを追加
    , verbose=2       # 学習中の進捗ログの表示スタイル
)
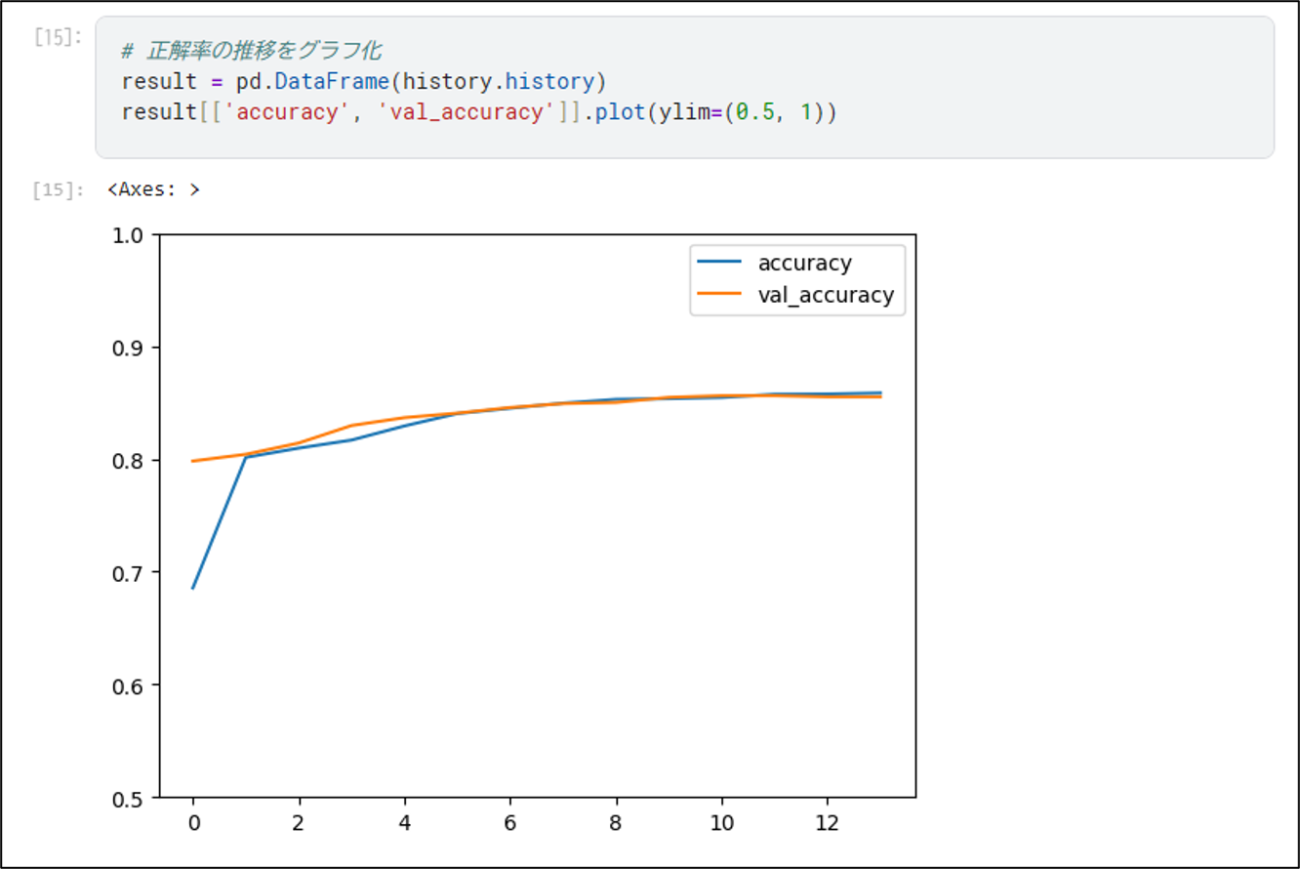
4) 3)の正解率をグラフ化する実装例は、以下の通り。
# 正解率の推移をグラフ化
result = pd.DataFrame(history.history)
result[['accuracy', 'val_accuracy']].plot(ylim=(0.5, 1))
要点まとめ
- DNN(ディープニューラルネットワーク:Deep Neural Network)とは、人間の脳の神経回路を模した人工ニューラルネットワークを多層化し、複雑なデータから高精度な特徴を自動で学習する深層学習(ディープラーニング)の中心的な技術である。
- DNNの実装には、フレームワークTensorFlowに内蔵されているKerasを利用できる。