Kaggleのタイタニックコンペで作成した機械学習モデルをさまざまな切り口で評価してみた
作成した機械学習モデルを評価するには、正解率(精度)だけでなく、陽性と予測したデータのうち実際に陽性だった割合を示す「適合率」や、実際に陽性であるデータのうち正しく陽性と予測できた割合を示す「再現率」といった性能指標を考慮したり、2つのカテゴリに分類する予測モデルや検査の性能を評価するための「ROC曲線」を描画して検証する必要がある。
また、作成した機械学習モデルを評価する方法には、訓練データによる検証を1回だけ行う「ホールドアウト法」や、データの分割を何度も繰り返し検証する「交差検証」がある。
今回は、Kaggleのタイタニックコンペで作成した機械学習モデルを、上記のような観点で評価してみたので、その手順を共有する。
なお、混合行列や性能指標の計算については、以下のサイトを参照のこと。
https://qiita.com/TsutomuNakamura/items/a1a6a02cb9bb0dcbb37f
また、ROC曲線については、以下のサイトを参照のこと。
https://bellcurve.jp/statistics/glossary/2167.html
さらに、ホールドアウト法と交差検証については、以下のサイトを参照のこと。
https://www.azusuki.com/how-to-ai-test/
前提条件
下記記事の実装が完了していること。
モデルの評価
前提条件の記事の実装により作成したモデルを、さまざまな切り口で評価した結果は、以下の通り。
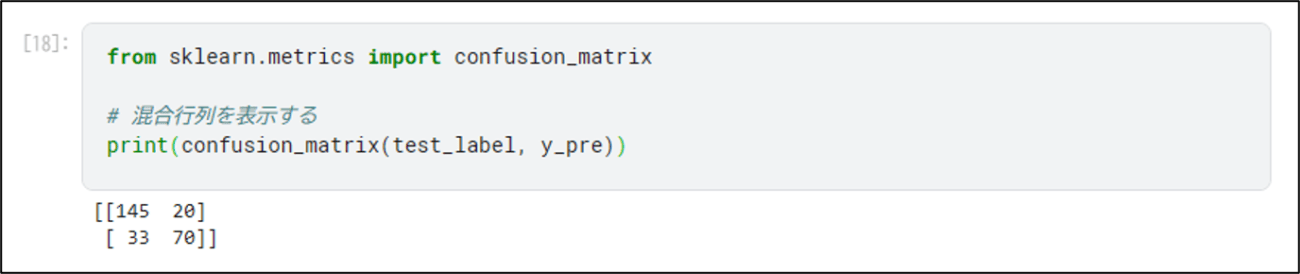
1) confusion_matrix関数を利用して、混合行列を表示した結果は、以下の通り。
from sklearn.metrics import confusion_matrix

# 混合行列を表示する
print(confusion_matrix(test_label, y_pre))
2) confusion_matrix関数を利用しないで、混合行列の各値を計算した結果は、以下の通り。
print('正解値(ラベル)(先頭5個):{0}'.format(test_label[0:5].values.tolist()))
print('予測値(先頭5個):{0}'.format(y_pre[0:5].tolist()))
print('正解値(ラベル)の数:{0}'.format(len(test_label)))
print('予測値の数:{0}'.format(len(y_pre)))
print()

# 0を陽性として、下記値を算出する
tp_val = 0  # TP (True Positive / 真陽性)
fn_val = 0  # FN (False Negative / 偽陰性)
fp_val = 0  # FP (False Positive / 偽陽性)
tn_val = 0  # TN (True Negative / 真陰性)

for idx in range(len(y_pre)):
    y_pre_val = y_pre[idx]
    test_label_val = test_label.values.tolist()[idx]
    if y_pre_val == 0 and test_label_val == 0:
        tp_val += 1
    elif y_pre_val == 1 and test_label_val == 0:
        fn_val += 1
    elif y_pre_val == 0 and test_label_val == 1:
        fp_val += 1
    elif y_pre_val == 1 and test_label_val == 1:
        tn_val += 1
    else:
        pass

print('TP (True Positive / 真陽性)の値:{0}'.format(tp_val))
print('FN (False Negative / 偽陰性)の値:{0}'.format(fn_val))
print('FP (False Positive / 偽陽性)の値:{0}'.format(fp_val))
print('TN (True Negative / 真陰性)の値:{0}'.format(tn_val))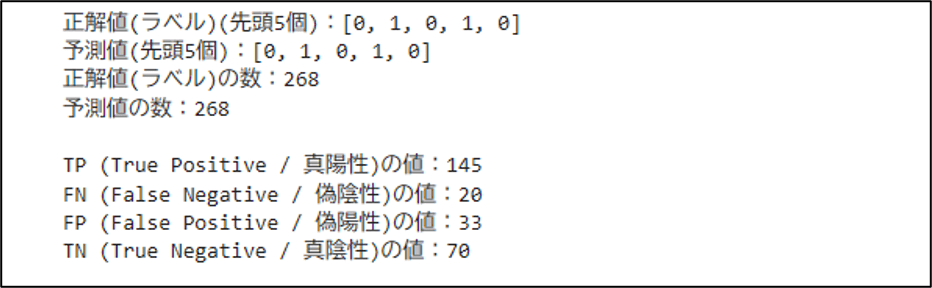
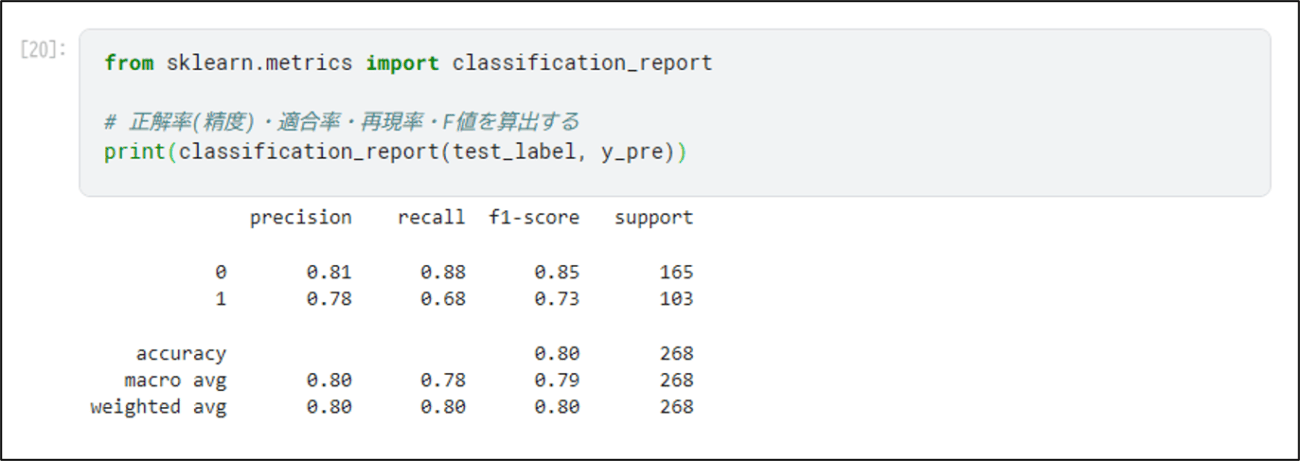
3) classification_report関数を利用して、正解率(精度)・適合率・再現率・F値を計算した結果は、以下の通り。
from sklearn.metrics import classification_report

# 正解率(精度)・適合率・再現率・F値を算出する
print(classification_report(test_label, y_pre))
4) classification_report関数を利用しないで、正解率(精度)・適合率・再現率・F値を計算した結果は、以下の通り。
# 先ほどの結果の0を陽性として、正解率(精度)・適合率・再現率・F値を手動で算出した結果
accuracy = (145 + 70) / (145 + 20 + 33 + 70)
precision = 145 / (145 + 33)
recall = 145 / (145 + 20)
f1_score = 2 * precision * recall / (precision + recall)

print("正解率(精度)(accuracy) : {0:.2f}".format(accuracy))
print("適合率(precision) : {0:.2f}".format(precision))
print("再現率(recall) : {0:.2f}".format(recall))
print("F値(f1-score) : {0:.2f}".format(f1_score))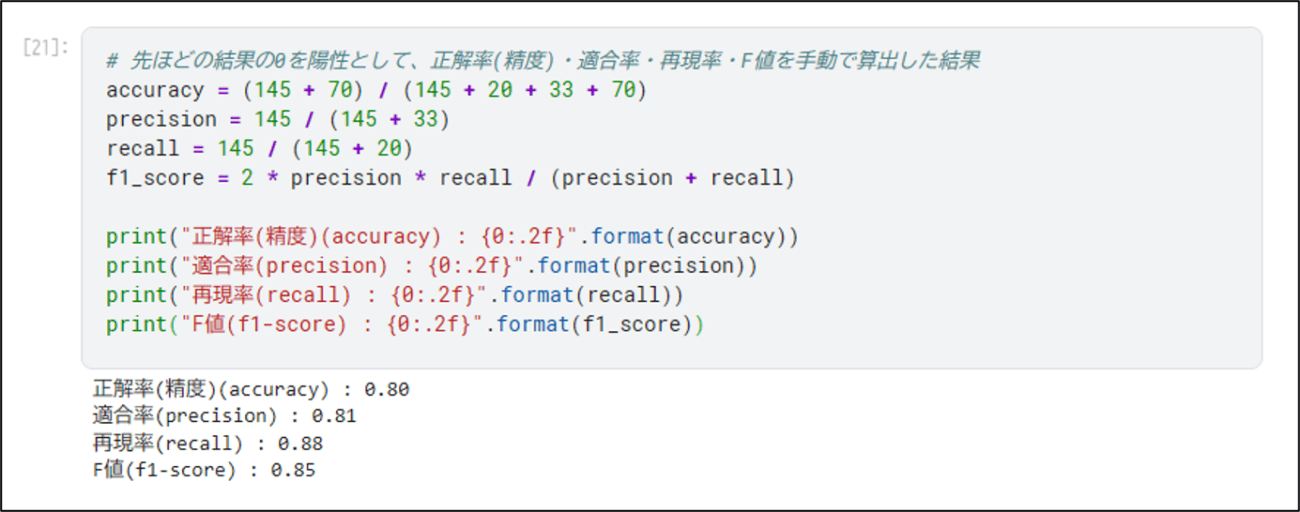
5) AUCスコアの算出と、ROC曲線のグラフ描画を行った結果は、以下の通り。
from sklearn.metrics import roc_curve, auc
import matplotlib.pyplot as plt

# 各テストデータがそれぞれのクラス(カテゴリ)に属する確率を算出
y_scores = clf.predict_proba(test_data)[: , 1]

# 偽陽性率(fpr)、真陽性率(tpr)、閾値(thresholds)、AUCスコア(roc_auc)を算出
fpr, tpr, thresholds = roc_curve(test_label, y_scores)
roc_auc = auc(fpr, tpr)

# ROC曲線を描画
# 算出したAUCスコア(roc_auc)も表示
plt.figure(figsize=(6, 5))
plt.plot(fpr, tpr, color='darkorange', lw=2, label=f'ROC curve (AUC = {roc_auc:.2f})')
plt.plot([0, 1], [0, 1], color='navy', lw=2, linestyle='--')
plt.xlabel('False Positive Rate(FPR)')
plt.ylabel('True Positive Rate(TPR)')
plt.title('ROC Curve')
plt.legend(loc="lower right")
plt.grid(True)
plt.show()
6) ホールドアウト法でテストデータの正解率を算出した結果は、以下の通り。
# ホールドアウト法でテストデータの正解率を算出
holdout_score = clf.score(test_data, test_label)
print("ホールドアウト法での正解率 : {0:.1f}%".format(holdout_score * 100))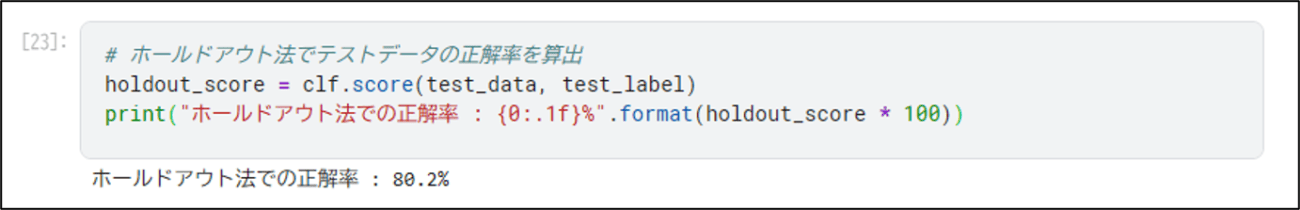
7) 交差検証でテストデータの正解率を算出した結果は、以下の通り。
from sklearn.model_selection import cross_val_score

# 交差検証でテストデータの正解率を算出
# 分割数(cv)は5とする
scores = cross_val_score(clf, train_data, train_label, cv=5)

# 各分割毎の正解率
formatted_scores = [round(score * 100, 2) for score in scores]
print("交差検証の各分割毎の正解率(%) : {0}".format(formatted_scores))

# 各分割毎の正解率の平均
print("交差検証の正解率の平均 : {0:.1f}%".format(scores.mean() * 100))
要点まとめ
- 作成した機械学習モデルを評価するには、正解率(精度)だけでなく、適用率・再現率・F値を考慮したり、ROC曲線を描画して検証する必要がある。
- 作成した機械学習モデルを評価する方法には、1回だけ検証する「ホールドアウト法」に加え、データの分割を何度も繰り返し検証する「交差検証」がある。