Kaggleのタイタニックコンペで前処理を行い機械学習モデルを作成してみた
Kaggleは、約100万人以上の方が利用している世界最大のデータサイエンスコンペティションプラットフォームで、企業や政府等がコンペティション形式で課題を提示し、参加者がその課題に挑戦する形式になっていて、優れた回答を提示したと判断されると報酬が支払われる仕組みになっている。
今回は、Kaggleのタイタンニックコンペで訓練データの前処理を行った上で、機械学習モデルを作成してみたので、その手順を共有する。
前提条件
下記記事のKaggleのアカウント登録が完了していて、Kaggleのタイタンニックコンペでコード実行できる状態になっていること。
データの読み込みと前処理
Kaggleのタイタンニックコンペで、訓練データ(train.csv)を読み込み前処理する実装例は、以下の通り。
1) 以下のようにライブラリを読み込み、inputファイル名を確認する。
# ライブラリを読み込む
import numpy as np
import pandas as pd
import os
import seaborn as sns
# ファイル名を一覧表示する
for dirname, _, filenames in os.walk('/kaggle/input'):
    for filename in filenames:
        print(os.path.join(dirname, filename))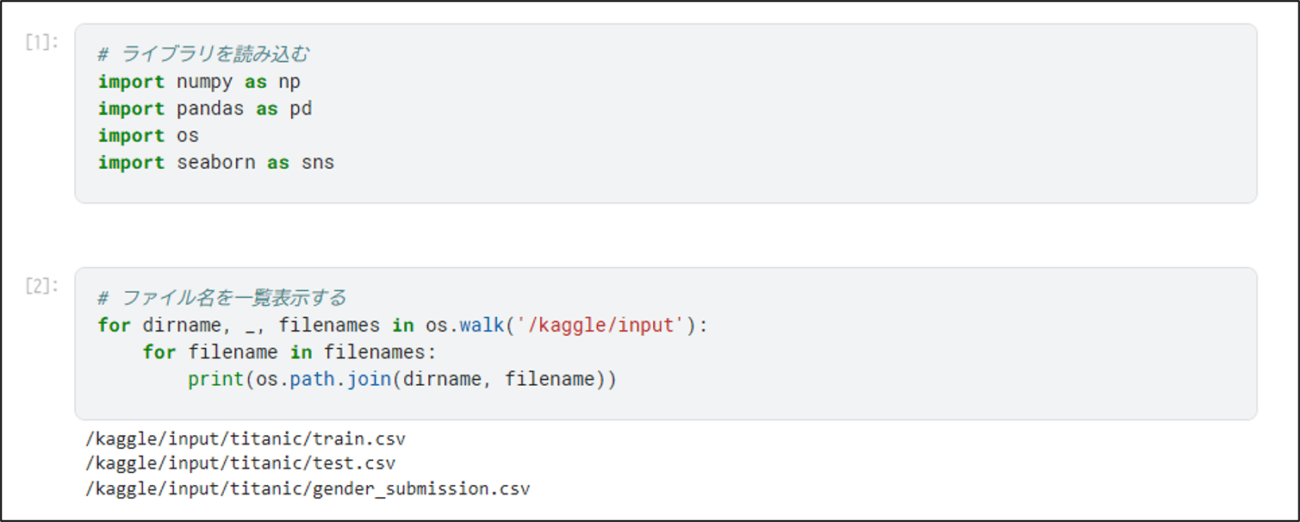
2) インプットファイルのうち、「train.csv」を読み込む。
# train.csvを読み込む
train_csv = pd.read_csv('/kaggle/input/titanic/train.csv', header=0, encoding='UTF-8')
print(train_csv.shape)
train_csv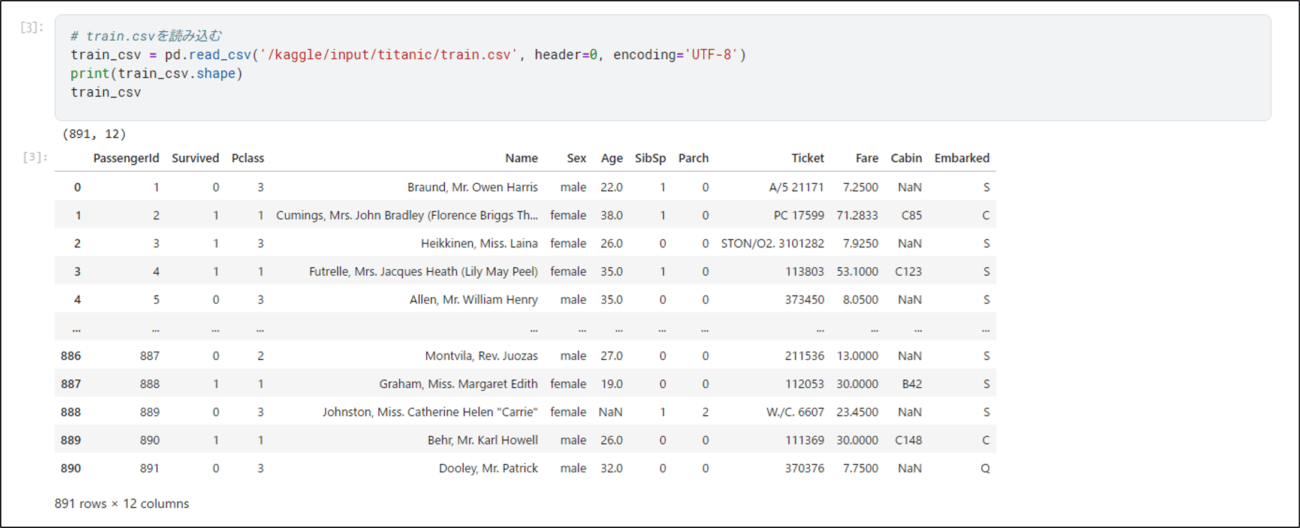
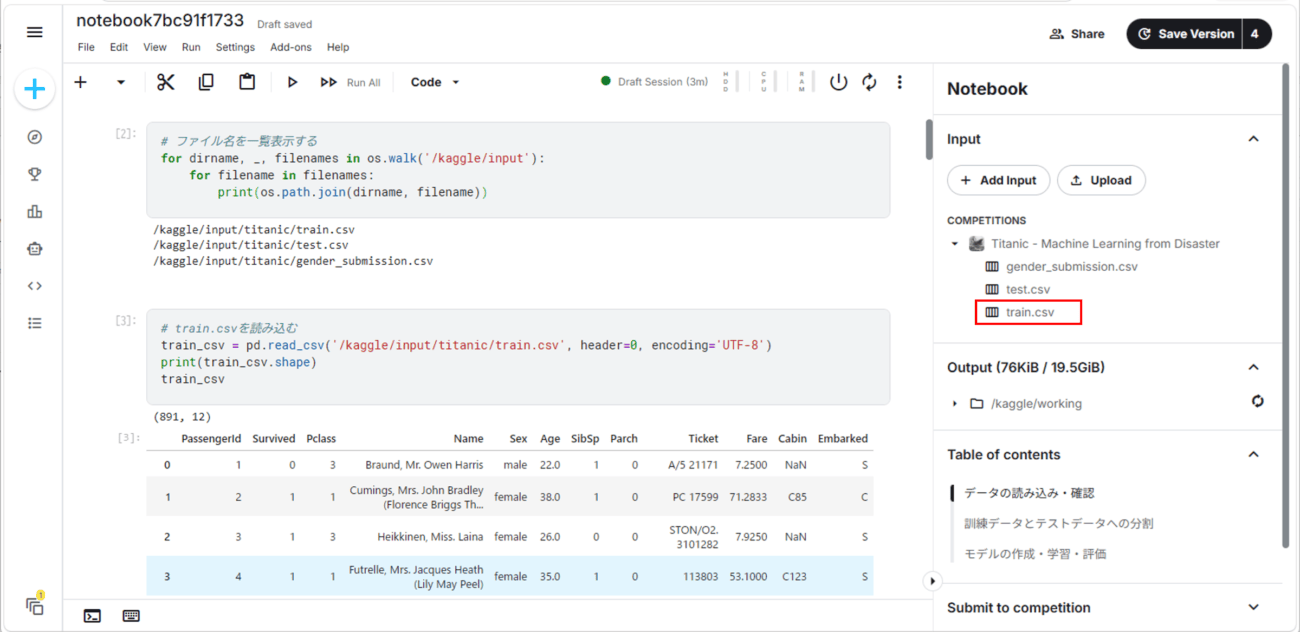
なお、上記で読み込むCSVファイルは、以下の赤枠の場所にある。
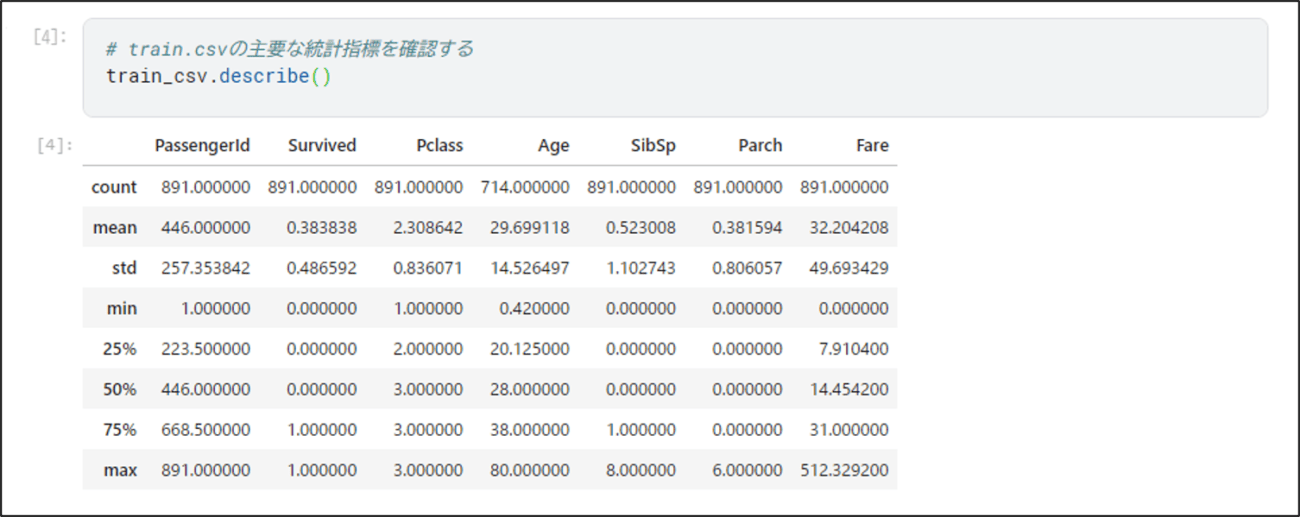
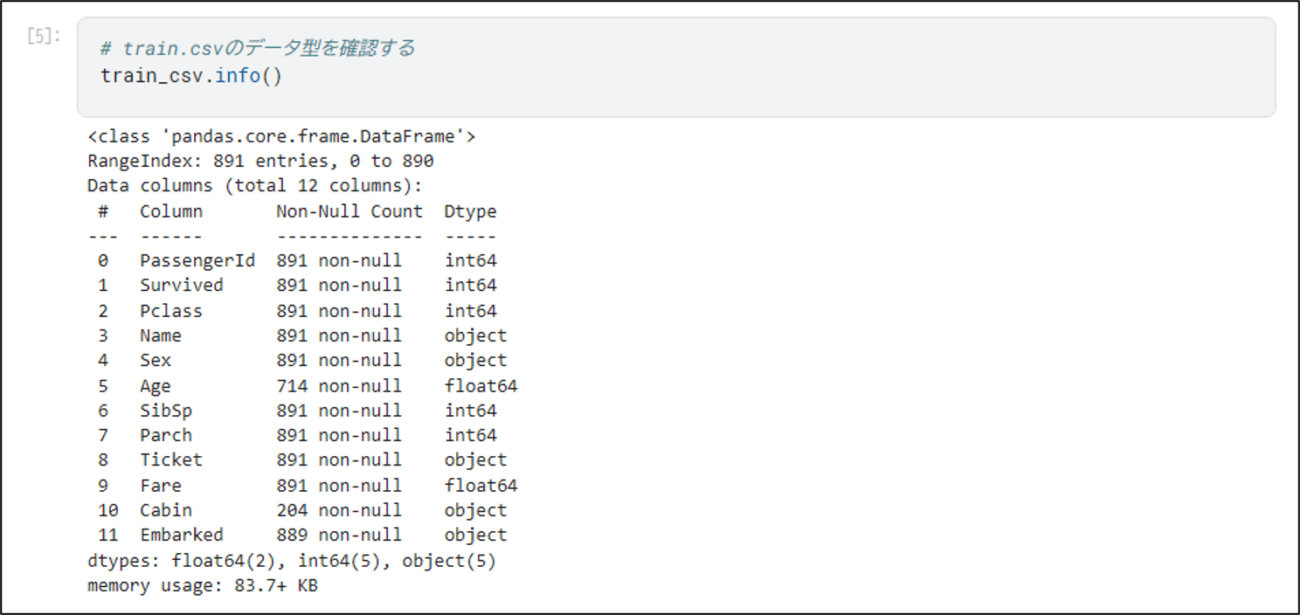
3) 2)で読み込んだファイルの統計指標・データ型・欠損値数を確認する。
# train.csvの主要な統計指標を確認する
train_csv.describe()
# train.csvのデータ型を確認する
train_csv.info()
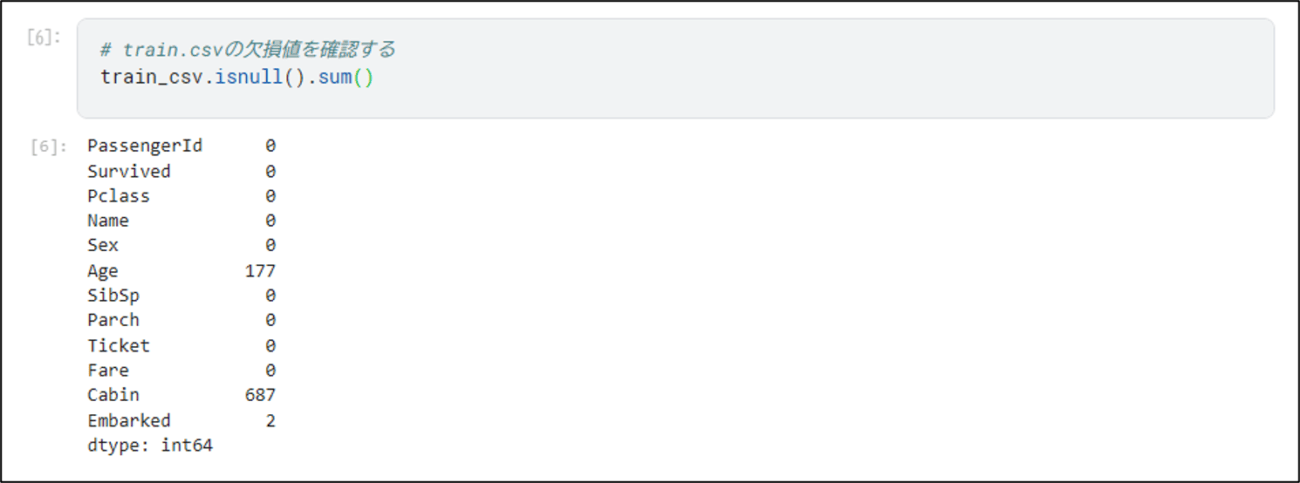
# train.csvの欠損値を確認する
train_csv.isnull().sum()
4) 2)で読み込んだファイルから、特定の列を削除する。
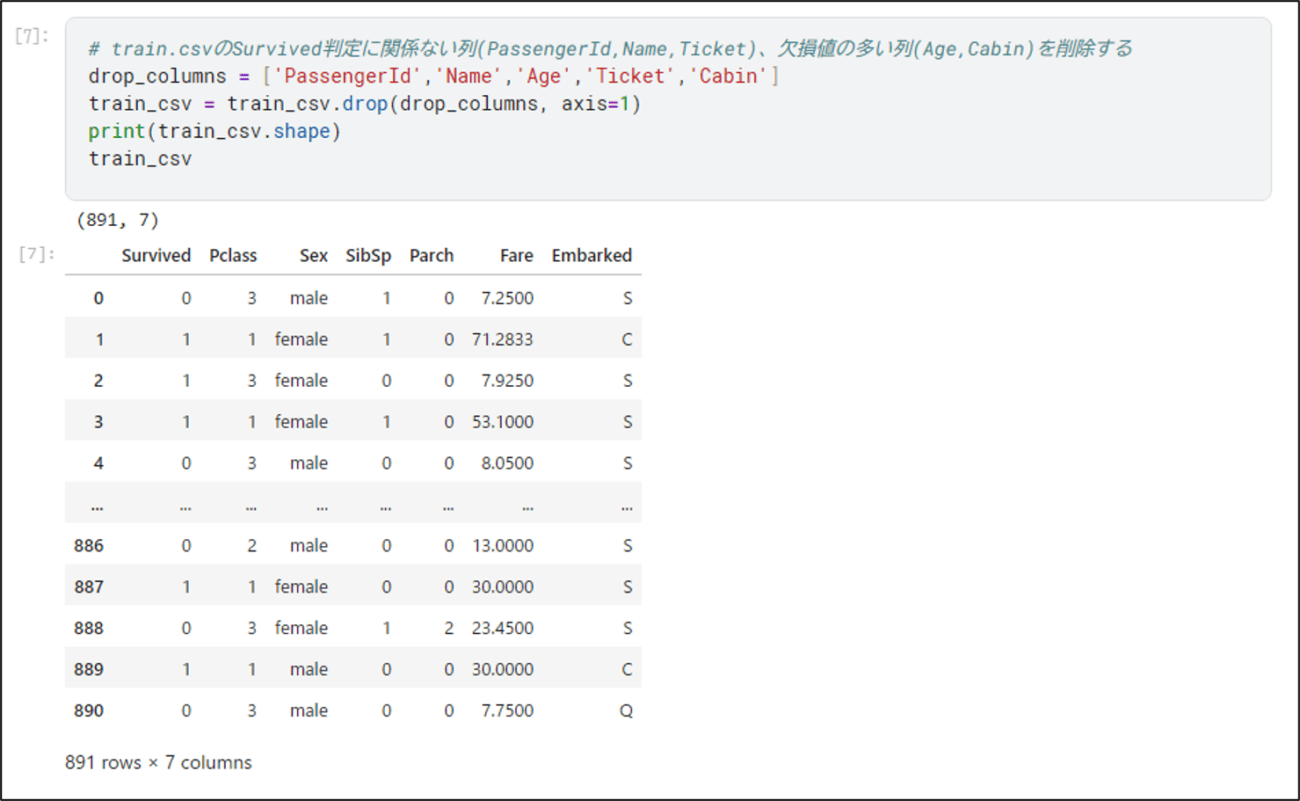
# train.csvのSurvived判定に関係ない列(PassengerId,Name,Ticket)、欠損値の多い列(Age,Cabin)を削除する
drop_columns = ['PassengerId','Name','Age','Ticket','Cabin']
train_csv = train_csv.drop(drop_columns, axis=1)
print(train_csv.shape)
train_csv
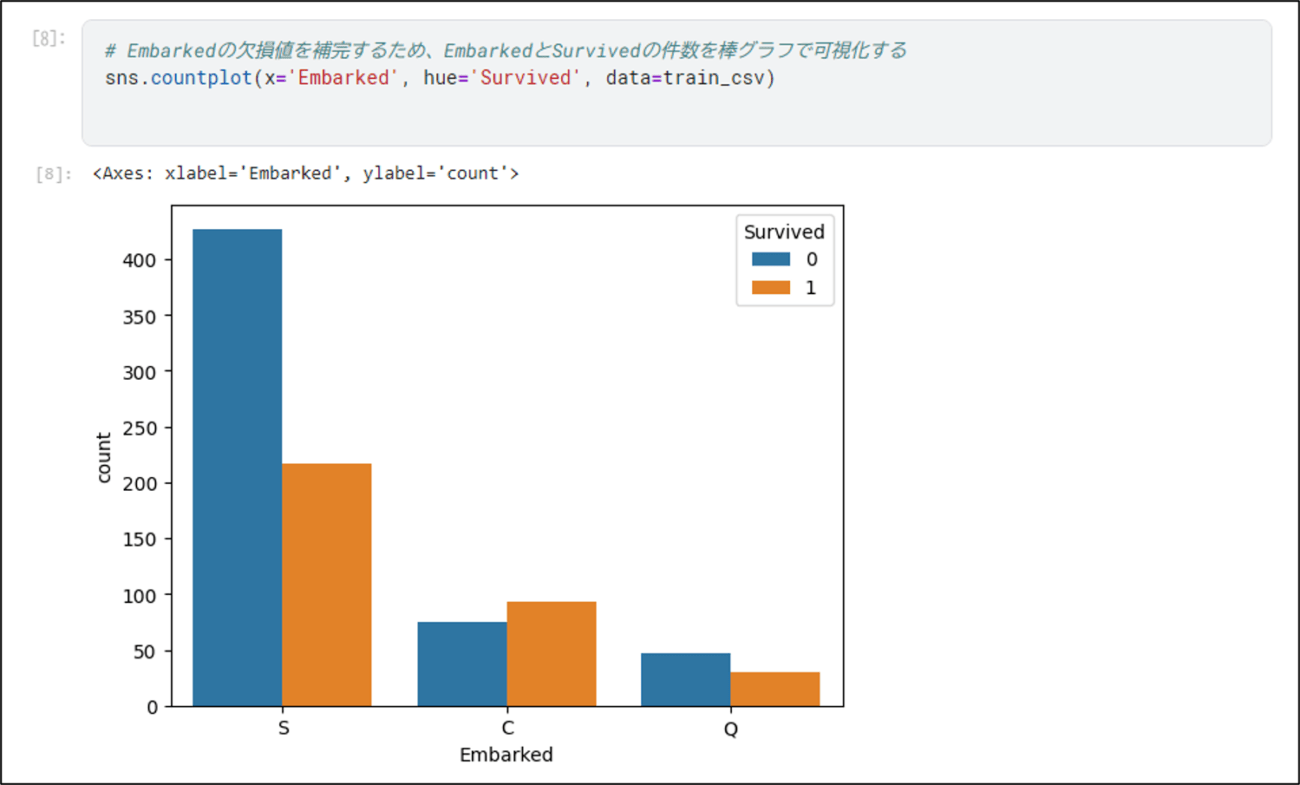
5) 2)で読み込んだファイルの「Embarked」を確認し、欠損値を補完する。
# Embarkedの欠損値を補完するため、EmbarkedとSurvivedの件数を棒グラフで可視化する
sns.countplot(x='Embarked', hue='Survived', data=train_csv)
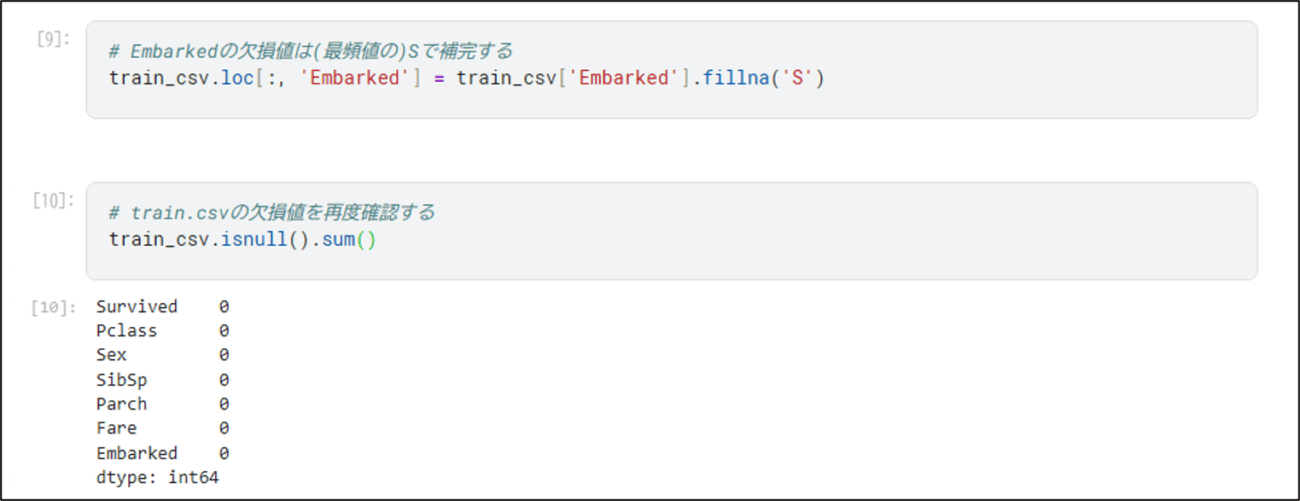
# Embarkedの欠損値は(最頻値の)Sで補完する
train_csv.loc[:, 'Embarked'] = train_csv['Embarked'].fillna('S')
# train.csvの欠損値を再度確認する train_csv.isnull().sum()
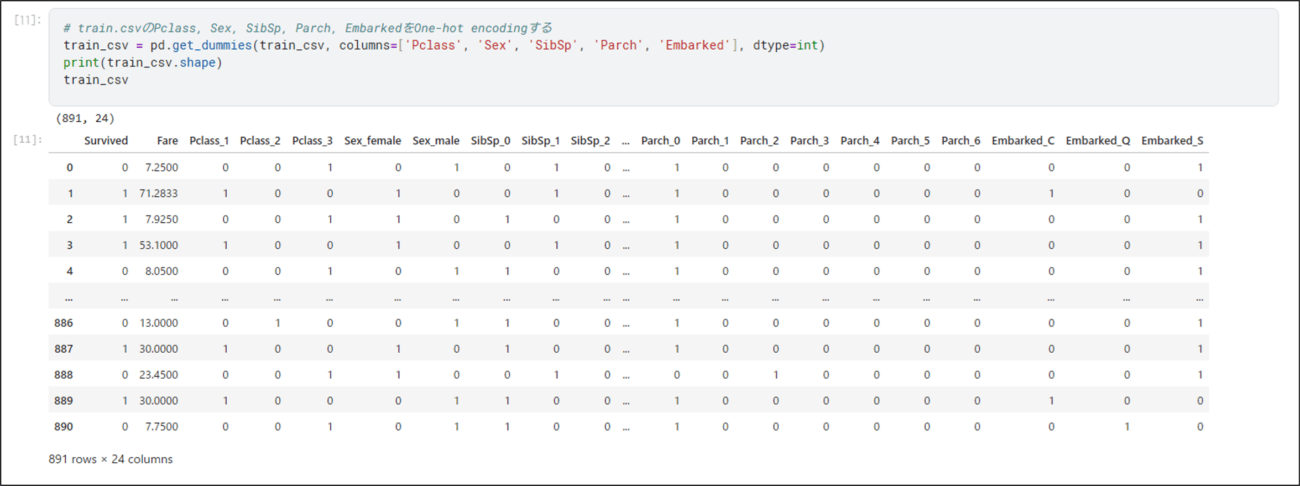
6) 2)で読み込んだファイルのカテゴリカルデータ(文字や分類のデータ)をOne-hot encoding(「0」と「1」の並び(数値のベクトル)に変換する)を行う。
# train.csvのPclass, Sex, SibSp, Parch, EmbarkedをOne-hot encodingする
train_csv = pd.get_dummies(train_csv, columns=['Pclass', 'Sex', 'SibSp', 'Parch', 'Embarked'], dtype=int)
print(train_csv.shape)
train_csv
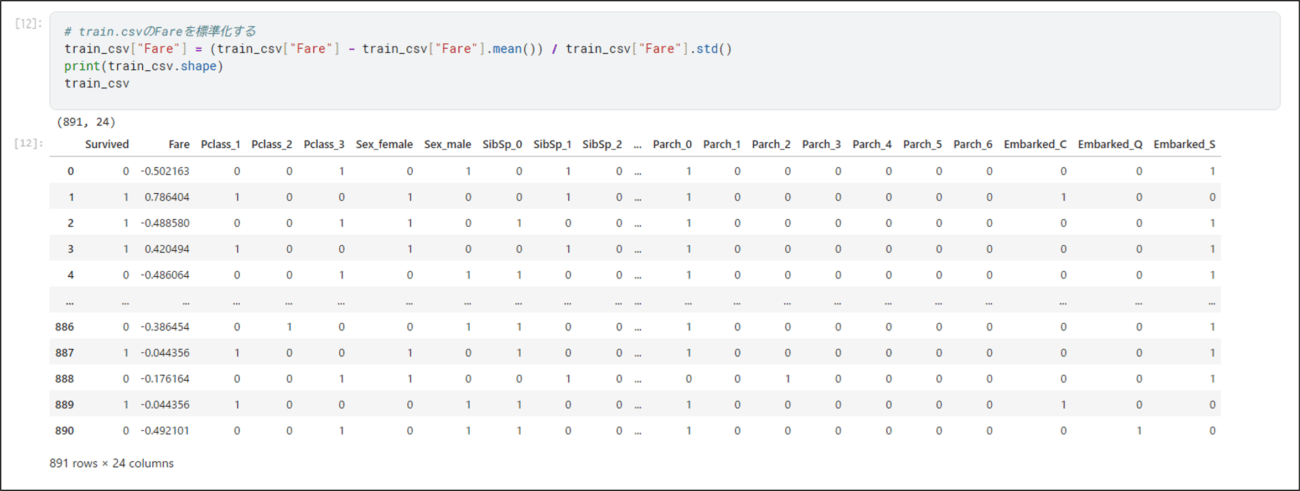
7) 2)で読み込んだファイルの「Fare」を標準化する。
# train.csvのFareを標準化する
train_csv["Fare"] = (train_csv["Fare"] - train_csv["Fare"].mean()) / train_csv["Fare"].std()
print(train_csv.shape)
train_csv
モデル作成と評価
Kaggleのタイタンニックコンペで、先述の前処理後の、モデル作成・評価の実装例は、以下の通り。
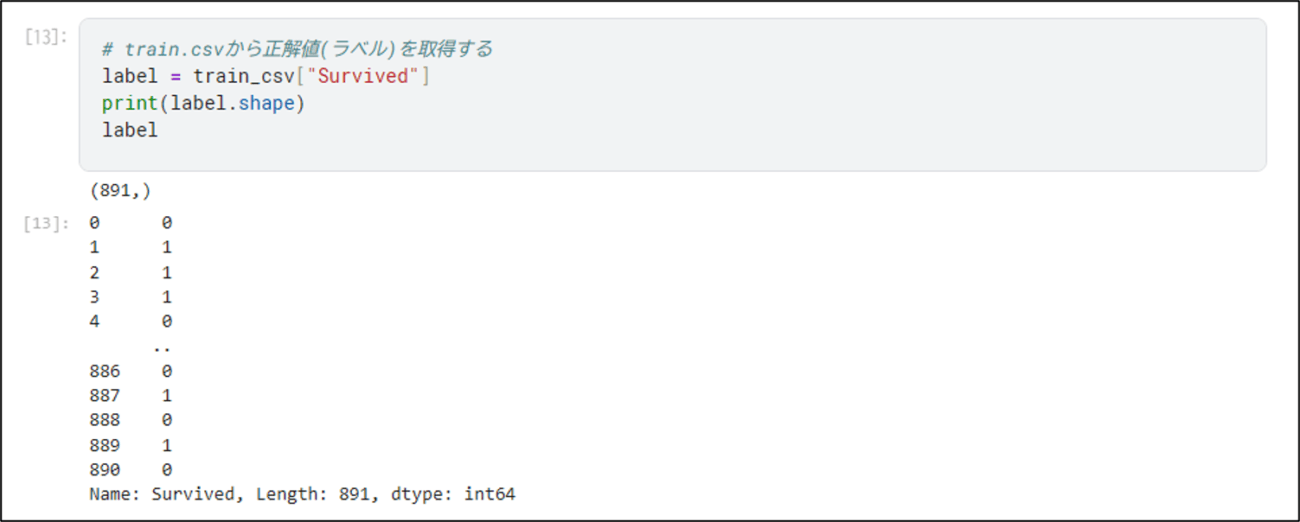
1) 読み込んだファイルから正解値(ラベル)を取得する。
# train.csvから正解値(ラベル)を取得する
label = train_csv["Survived"]
print(label.shape)
label
2) 読み込んだファイルから正解値(ラベル)を除去した値をデータに設定する。
# train.csvから正解値(ラベル)を除去した値をdataに格納する
data = train_csv.drop("Survived", axis=1)
print(data.shape)
data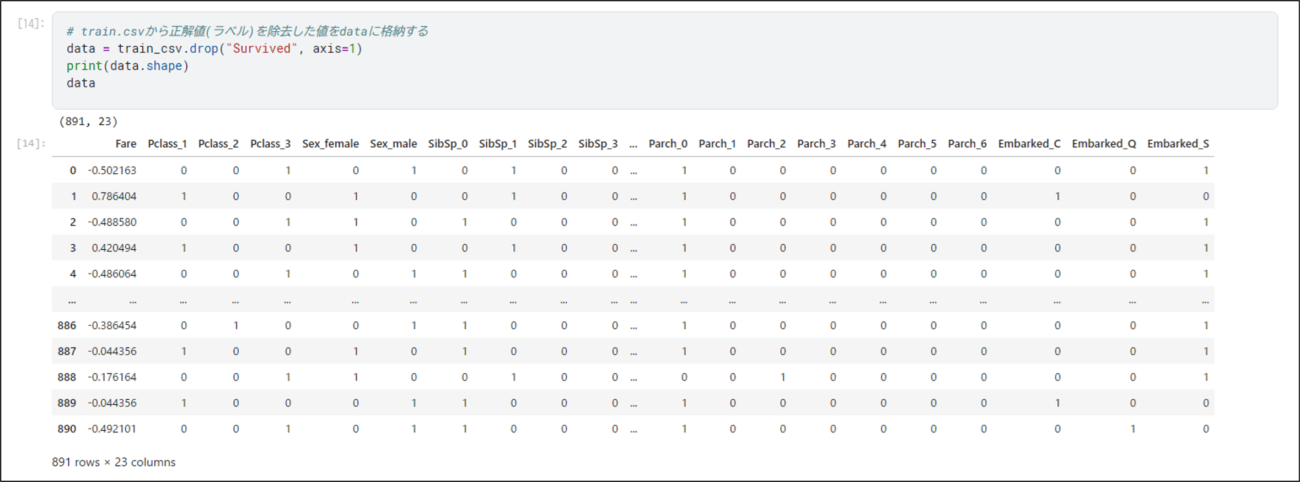
3) 1)2)のデータを訓練データとテストデータに分割する。
from sklearn.model_selection import train_test_split

# label, dataを訓練データとテストデータに分割する
# random_state : 実行結果を毎回固定するために指定
# stratify : 均等に分割したいデータ
# test_size : テストデータに利用したい割合
train_data, test_data, train_label, test_label = train_test_split(data, label, random_state=0, stratify=label, test_size=0.3)
print("train_data_shape : " + str(train_data.shape))
print("test_data_shape : " + str(test_data.shape))
print("train_label_shape : " + str(train_label.shape))
print("test_label_shape : " + str(test_label.shape))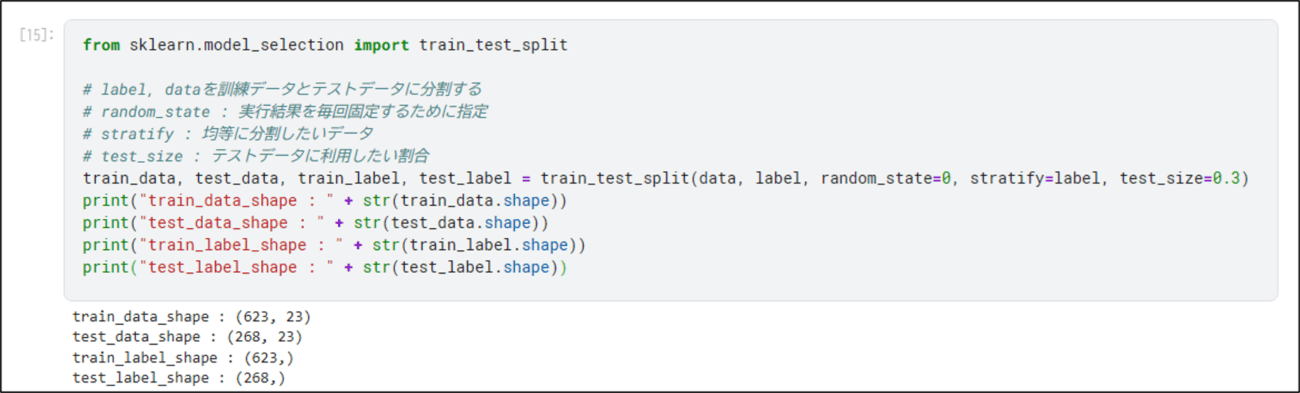
4) 機械学習モデル(下記ではロジスティックス回帰)を作成し学習する。
from sklearn.linear_model import LogisticRegression

# ロジスティックス回帰で学習する
clf = LogisticRegression(random_state=0)
clf.fit(train_data, train_label)
5) 4)で作成した機械学習モデルを評価する。
from sklearn import metrics

# テストデータで正解率を評価する
y_pre = clf.predict(test_data)
ac_score = metrics.accuracy_score(test_label, y_pre)
print('正解率{0:.1f}%'.format(ac_score * 100))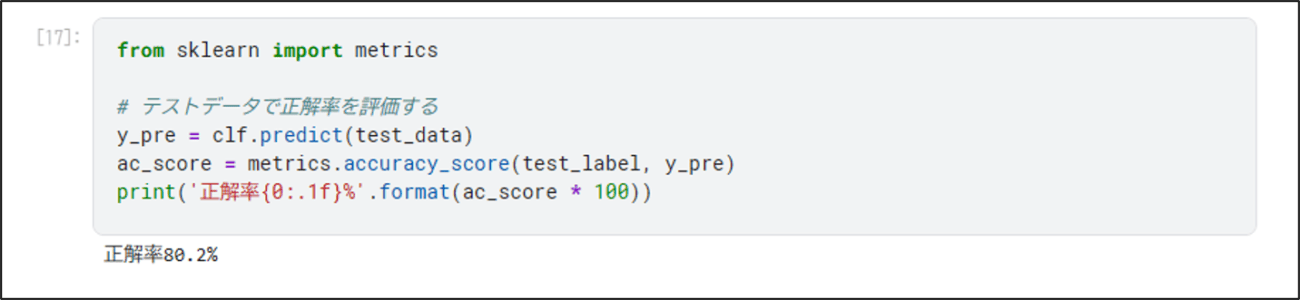
要点まとめ
- Kaggleのコンペを利用すると、用意されている訓練データを用いて、データの前処理や機械学習モデルの作成をいろいろ試すことができる。