Kaggleの自然言語処理のコンペでWord2Vecを利用してみた
自然言語を機械学習モデルで利用するには、自然言語を数値で表現できる必要があり、その手法の1つにWord2Vecがある。
今回は、Kaggleの自然言語処理のコンペでWord2Vecを利用してみたので、その手順を共有する。
なお、Word2Vecについては、以下のサイトを参照のこと。
https://www.kikagaku.co.jp/personal/blog/word2vec
前提条件
下記記事のKaggleのアカウント登録が完了していること。
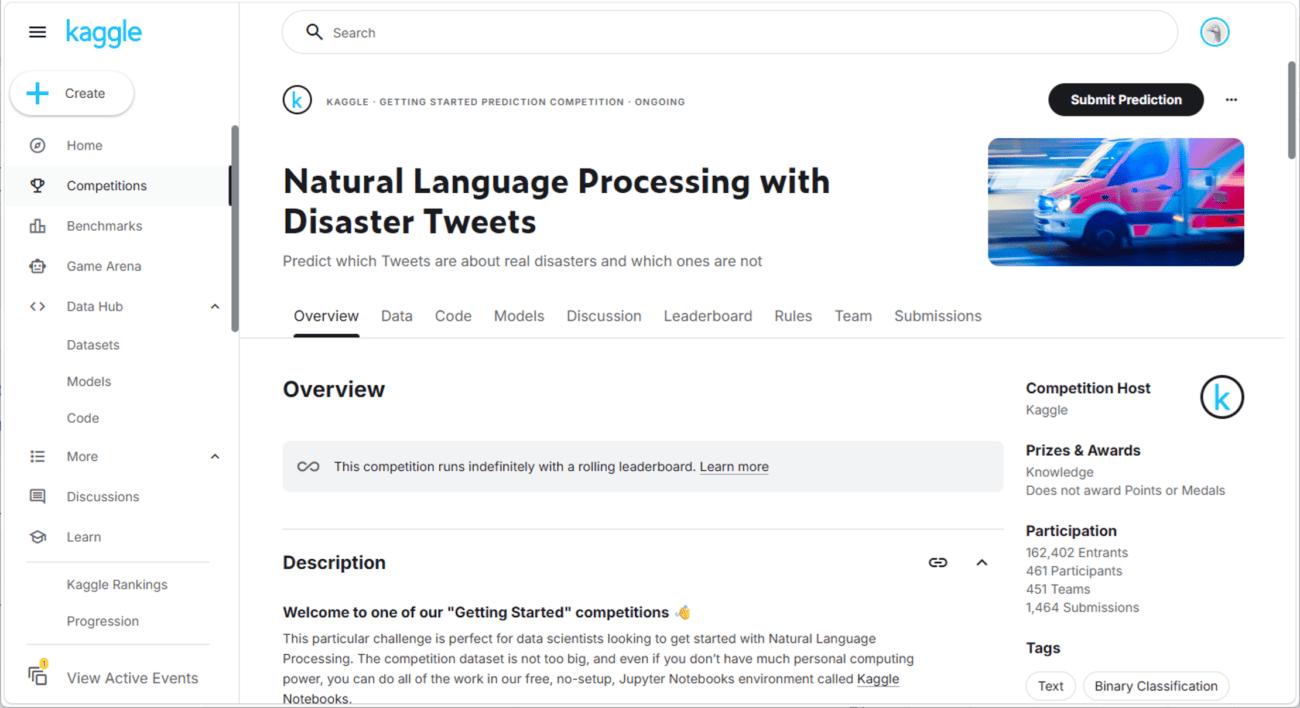
また、Kaggleの下記「Natural Language Processing with Disaster Tweets」コンペでコード実行できる状態になっていること。
やってみたこと
データの読み込みと確認
「Natural Language Processing with Disaster Tweets」コンペで、訓練データ・テストデータを読み込みデータを確認する実装例は、以下の通り。
1) 以下のようにライブラリを読み込み、inputファイル名を確認する。
# ライブラリを読み込む
import numpy as np
import pandas as pd
import os
# ファイル名を一覧表示する
for dirname, _, filenames in os.walk('/kaggle/input'):
    for filename in filenames:
        print(os.path.join(dirname, filename))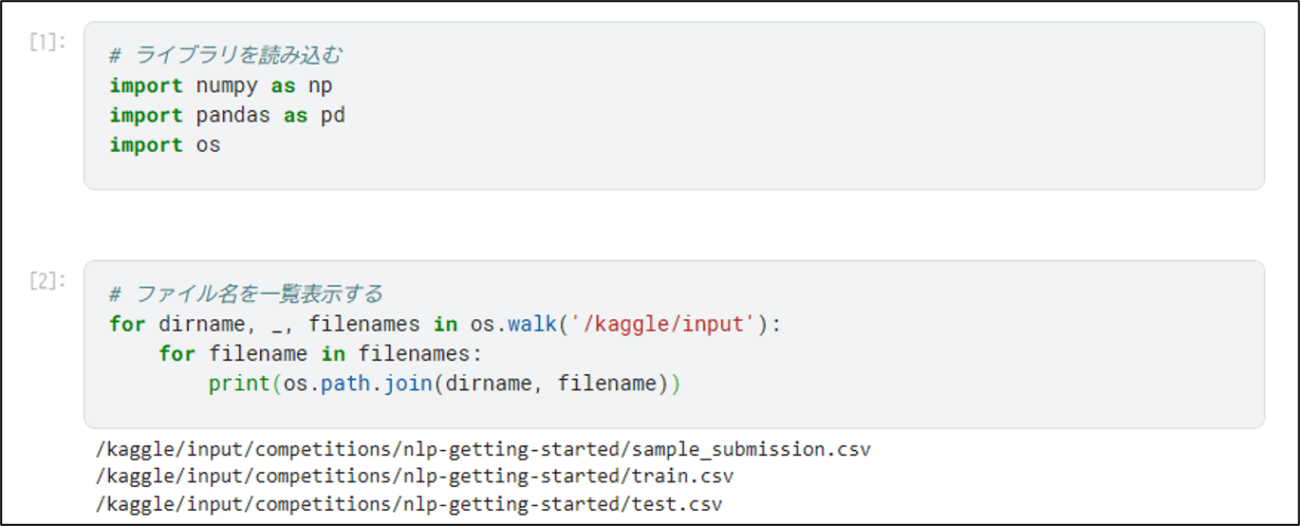
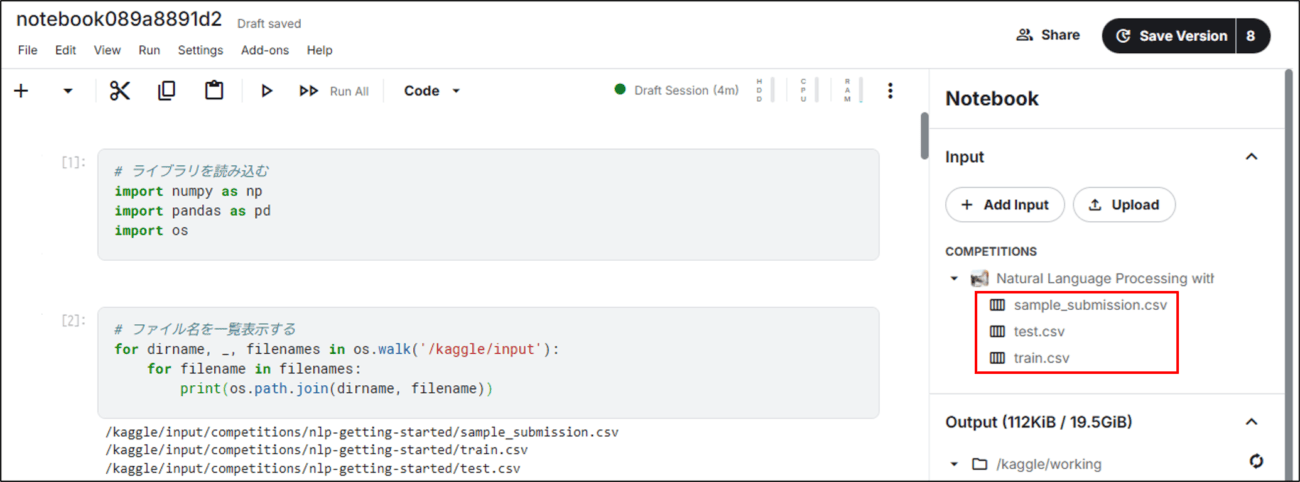
実際、以下のように、インプットファイルが配置されているのが確認できる。
2) インプットファイルのうち、「train.csv」「test.csv」を読み込む。
# train.csvを読み込む
train_csv = pd.read_csv('/kaggle/input/competitions/nlp-getting-started/train.csv', header=0, encoding='UTF-8')
print(train_csv.shape)
train_csv
# test.csvを読み込む
test_csv = pd.read_csv('/kaggle/input/competitions/nlp-getting-started/test.csv', header=0, encoding='UTF-8')
print(test_csv.shape)
test_csv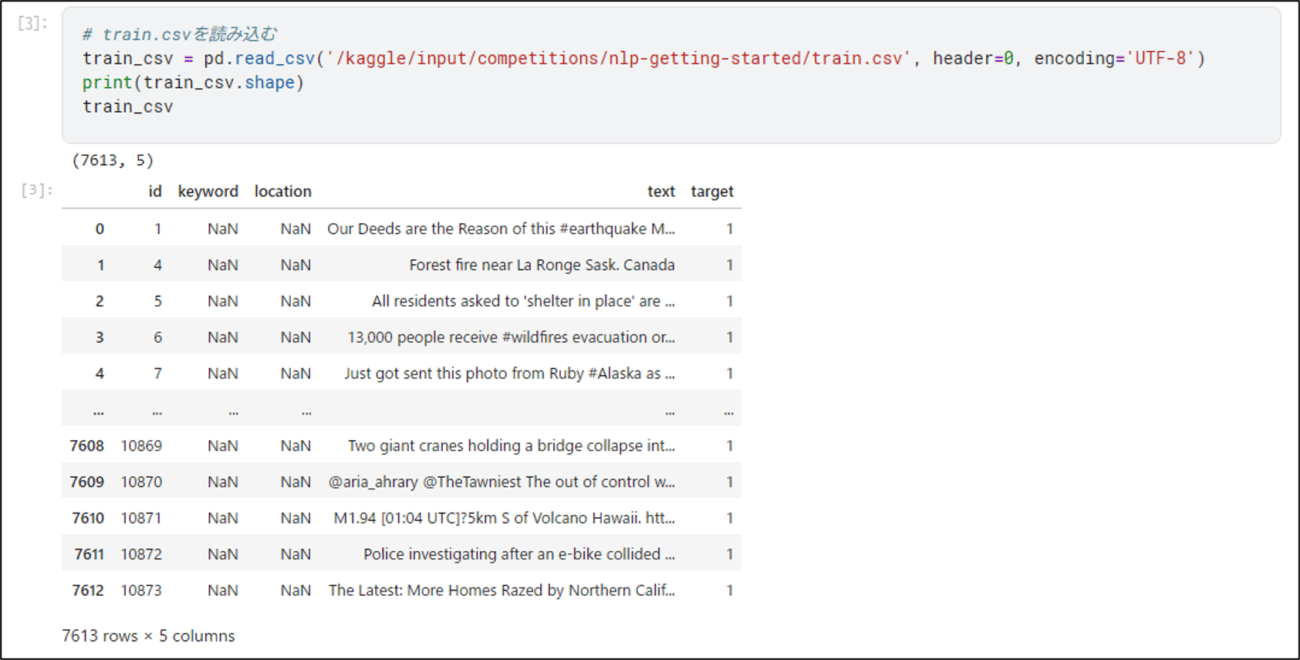
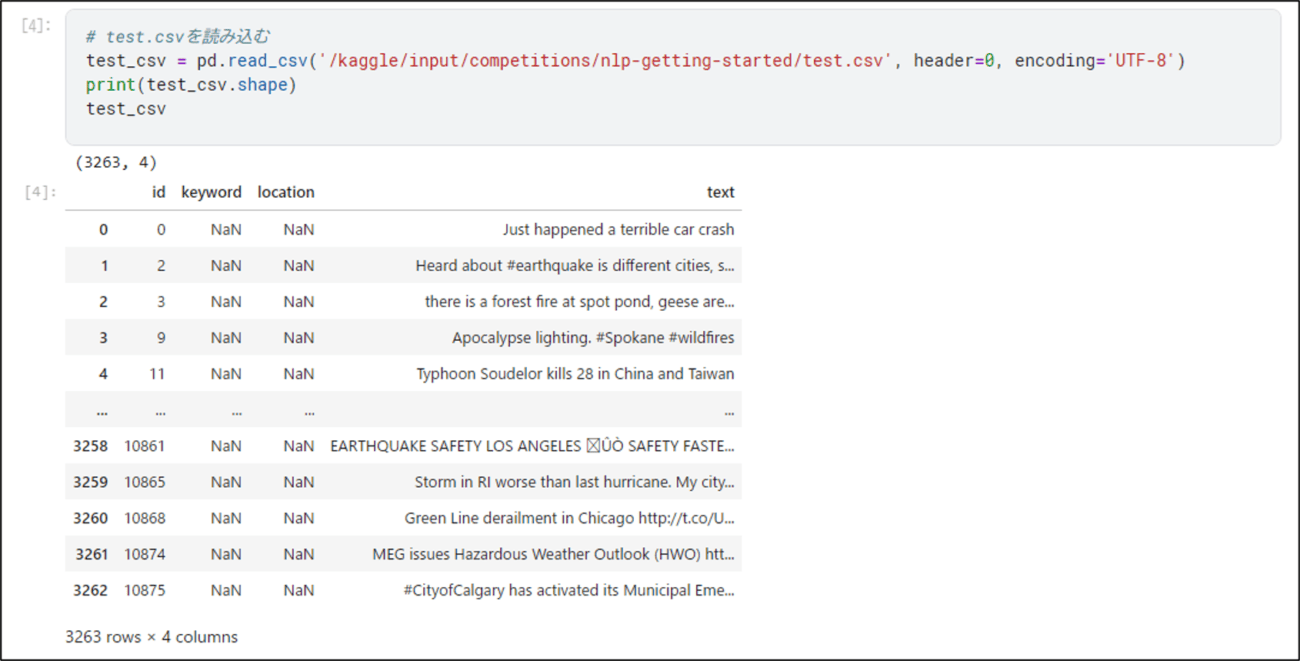
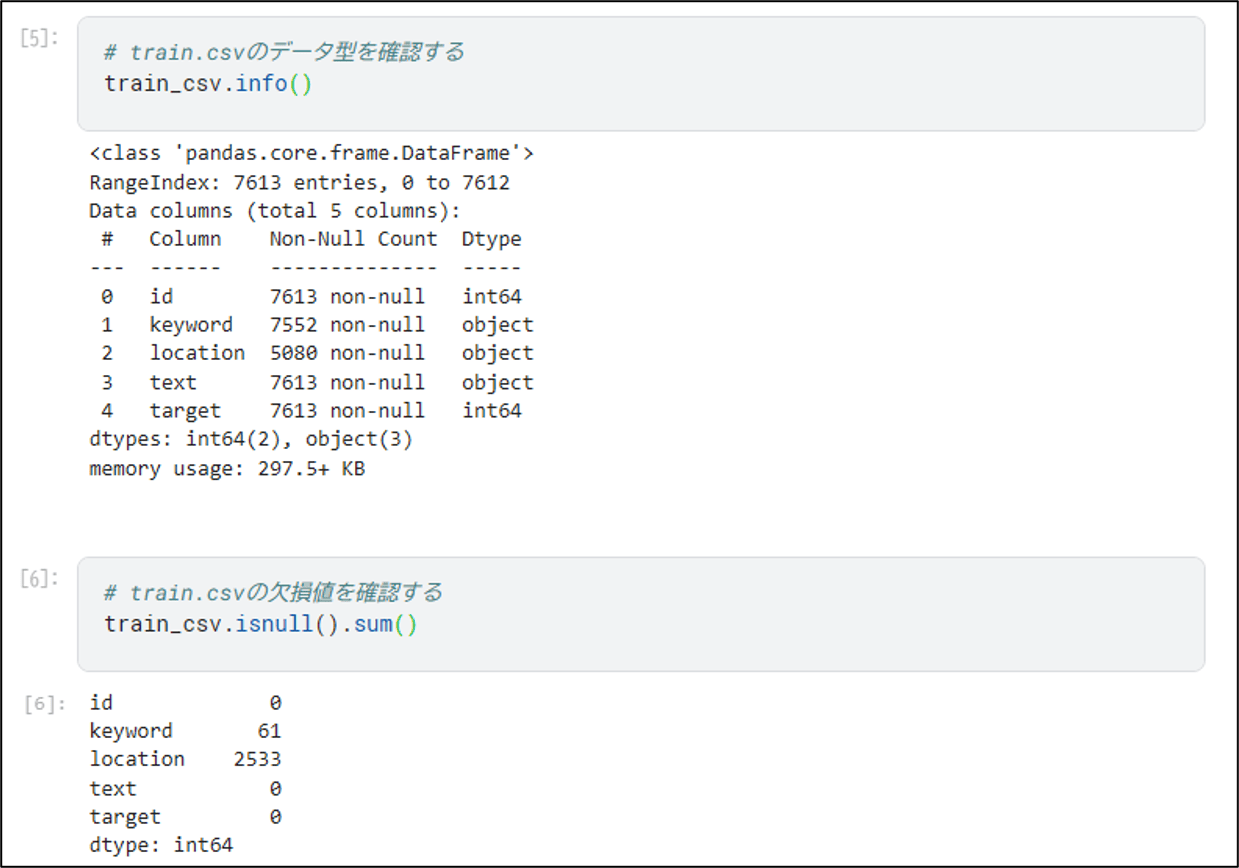
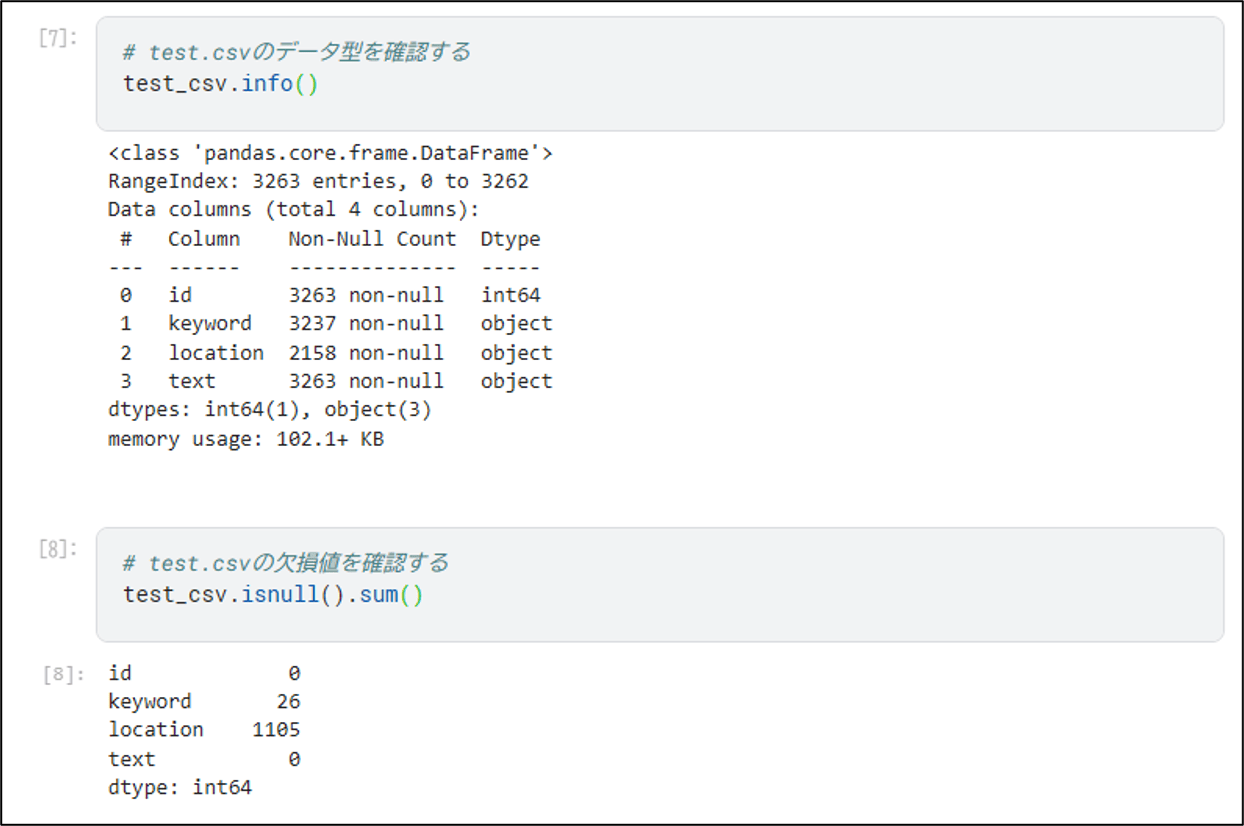
3) 2)で読み込んだファイルのデータ型・欠損値数を調べると、textデータが全て設定されているのが確認できる。
# train.csvのデータ型を確認する
train_csv.info()
# train.csvの欠損値を確認する
train_csv.isnull().sum()
# test.csvのデータ型を確認する
test_csv.info()
# test.csvの欠損値を確認する
test_csv.isnull().sum()
データの前処理とWord2Vecの利用
「Natural Language Processing with Disaster Tweets」コンペで、機械学習モデルに読ませるテキストデータ(text)の前処理を行う実装例は、以下の通り。
1) 機械学習モデルに読ませるテキストデータ(text)の前処理を行う関数を定義する。
import re
import string

# テキストデータの前処理を行う関数
def clean_text(text):
    # 小文字化
    text = text.lower()
    # HTML特殊文字の除去・変換 (例: & -> &)
    text = re.sub(r'&', 'and', text)
    text = re.sub(r'<', '<', text)
    text = re.sub(r'>', '>', text)
    # URLの除去 (http:// や https://, t.co など)
    text = re.sub(r'https?://\s+|www\.\s+', '', text)
    text = re.sub(r'http\S+|www\S+', '', text)
    # メンション (@username) の除去
    text = re.sub(r'@\w+', '', text)
    # 改行コードやタブをスペースに置換
    text = re.sub(r'[\r\n\t]', ' ', text)
    # 記号・句読点(Punctuation)の除去
    # string.punctuation に含まれる !"#$%&'()*+,-./:;<=>?@[\]^_`{|}~ を除去
    text = text.translate(str.maketrans('', '', string.punctuation))
    # 余分な空白の削除(2つ以上連続するスペースを1つに)
    text = re.sub(r'\s+', ' ', text).strip()
    words = text.split()
    return words
2) 1)の関数を利用し、訓練データ(train.csv)のテキストデータ(text)の前処理を行う。
# 訓練データ(train.csv)のtext全文の前処理を行う
train_csv['clean_text'] = [clean_text(text) for text in train_csv["text"]]

print("*** train_csv(text) 1データ分 ***")
print(train_csv["text"][0])
print("*** train_csv(clean_text) 1データ分 ***")
print(train_csv["clean_text"][0])
print("*** train_csv(clean_text) 全データ数 ***")
print(str(len(train_csv["clean_text"])))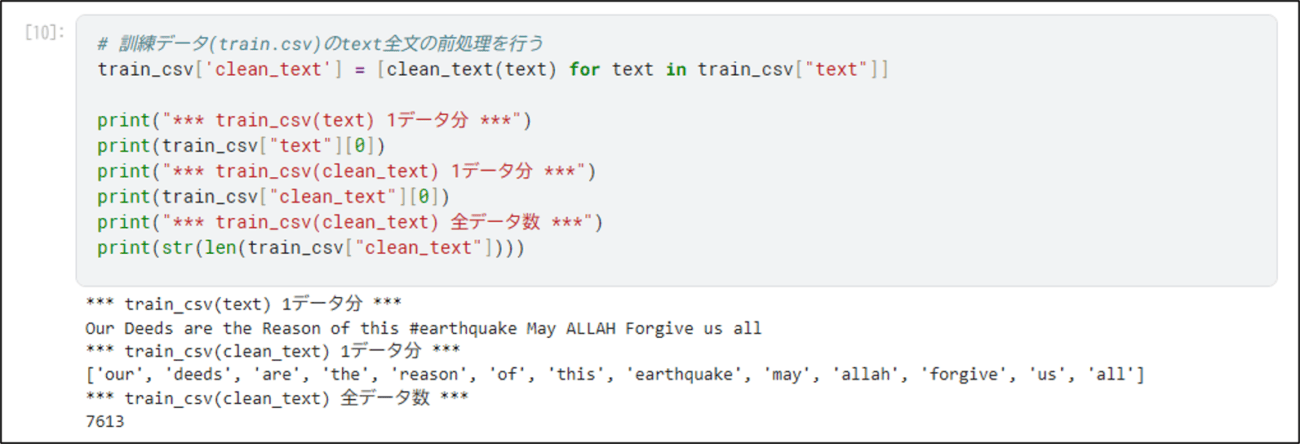
3) Word2Vecの学習に利用するため、1)の関数を利用し、テストデータ(test.csv)のテキストデータ(text)の前処理を行う。
# Word2Vecの学習には、訓練データとテストデータの両方のテキストを混ぜて使うと
# より多くの語彙や文脈を学習できるため有利になるため、テストデータも前処理する

# テストデータ(test.csv)のtext全文の前処理を行う
test_csv['clean_text'] = [clean_text(text) for text in test_csv["text"]]

print("*** test_csv(text) 1データ分 ***")
print(test_csv["text"][0])
print("*** test_csv(clean_text) 1データ分 ***")
print(test_csv["clean_text"][0])
print("*** test_csv(clean_text) 全データ数 ***")
print(str(len(test_csv["clean_text"])))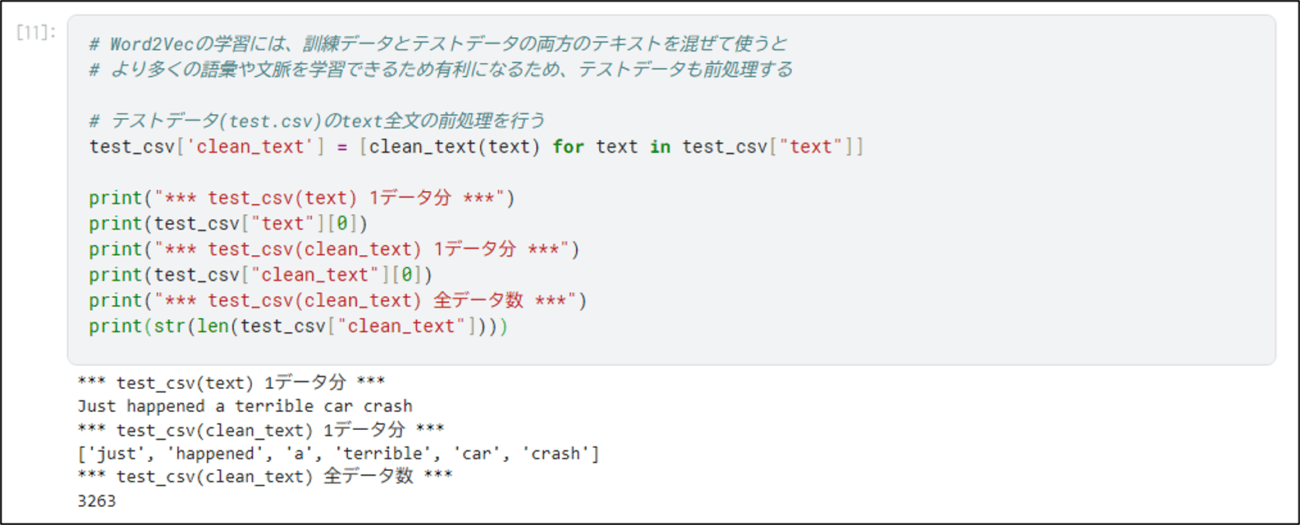
4) Word2Vecの学習に利用するため、前処理後の訓練データ(train.csv)とテストデータ(test.csv)のテキストデータ(text)を結合する。
# 順序が混ざらないよう、前処理済の訓練データとテストデータを用意する
train_sentences = [str(text).split() for text in train_csv['clean_text']]
test_sentences = [str(text).split() for text in test_csv['clean_text']]

# Word2Vecの学習には両方を混ぜたリストを渡す
all_sentences = train_sentences + test_sentences

print("*** train_sentences 1データ分 ***")
print(train_sentences[0])
print("*** test_sentences 1データ分 ***")
print(test_sentences[0])
print("*** train_sentences 全データ数 ***")
print(str(len(train_sentences)))
print("*** test_sentences 全データ数 ***")
print(str(len(test_sentences)))
print("*** all_sentences 全データ数 ***")
print(str(len(all_sentences)))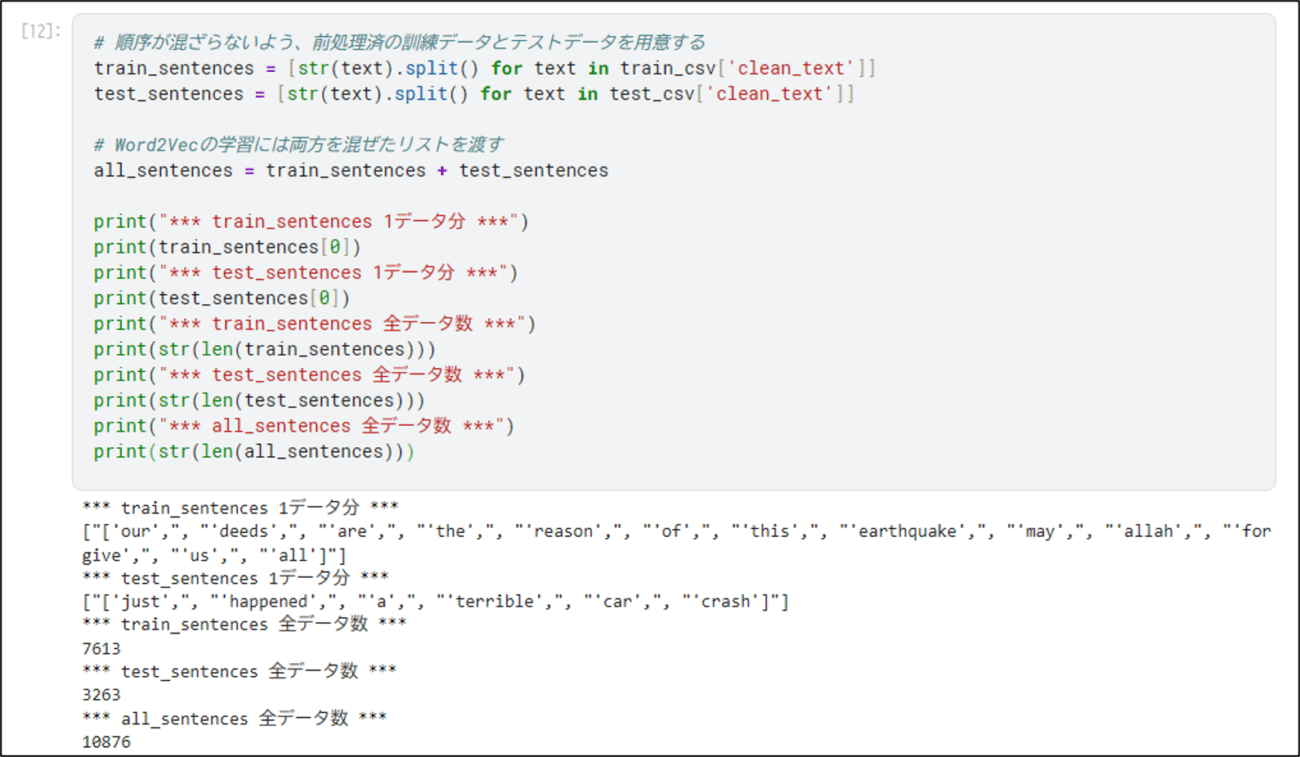
5) Word2Vecモデルの学習を行い、前処理後の訓練データ(train.csv)のテキストデータ(text)を、ベクトル(数値の配列)に変換する。
from gensim.models import Word2Vec

# 独自のWord2Vecモデルの学習を行う
w2v_model = Word2Vec(
    sentences=all_sentences,  # 学習に使用するテキストデータ(前処理済の訓練データとテストデータ)
    vector_size=200,          # ベクトルの次元数、各単語を200次元のベクトル(200個の数字の並び)に変換する
    window=5,                 # 周辺単語の幅、ターゲットとなる単語の前後5単語(合計10単語)を周辺文脈として考慮する
    min_count=2,              # 最小出現回数、テキスト全体の中で2回以上出現した単語のみを学習対象にする
    workers=4,                # 使用するCPUコア数、4つのCPUコアを使って並列処理(マルチスレッド)を行う
    epochs=25                 # 用意したテキストデータを25回繰り返し学習させる
)

# 文章(テキスト)を1つの「ベクトル(数値の配列)」に変換する処理
def tweet_to_vector(text, model):
    # 文章を単語に分解する
    words = str(text).split()
    # モデルに登録されている単語のベクトルの平均を返す
    # 有効な単語が1つもなかった場合は0ベクトルを返す
    word_vectors = [model.wv[word] for word in words if word in model.wv]
    if len(word_vectors) == 0:
        return np.zeros(model.vector_size)
    return np.mean(word_vectors, axis=0)

# 訓練データ(train.csv)の全データ分のテキストを「ベクトル(数値の配列)」に変換する
X_train_w2v = np.vstack([tweet_to_vector(text, w2v_model) for text in train_csv['clean_text']])
print("*** train_csv(text) 1データ分のテキストを「ベクトル(数値の配列)」に変換した結果 ***")
print(X_train_w2v[0])
print("*** train_csv(text) 1データ分のテキストを「ベクトル(数値の配列)」に変換した結果の形状 ***")
print(X_train_w2v[0].shape)
print("*** train_csv(text) 全データ分のテキストを「ベクトル(数値の配列)」に変換した結果の形状 ***")
print(X_train_w2v.shape)
print()

# 訓練データ(train.csv)のラベルを設定
y_train = train_csv['target'].values
print("*** train_csv(target) 1データ分 ***")
print(y_train[0])
print("*** train_csv(target) 全データ数 ***")
print(y_train.shape)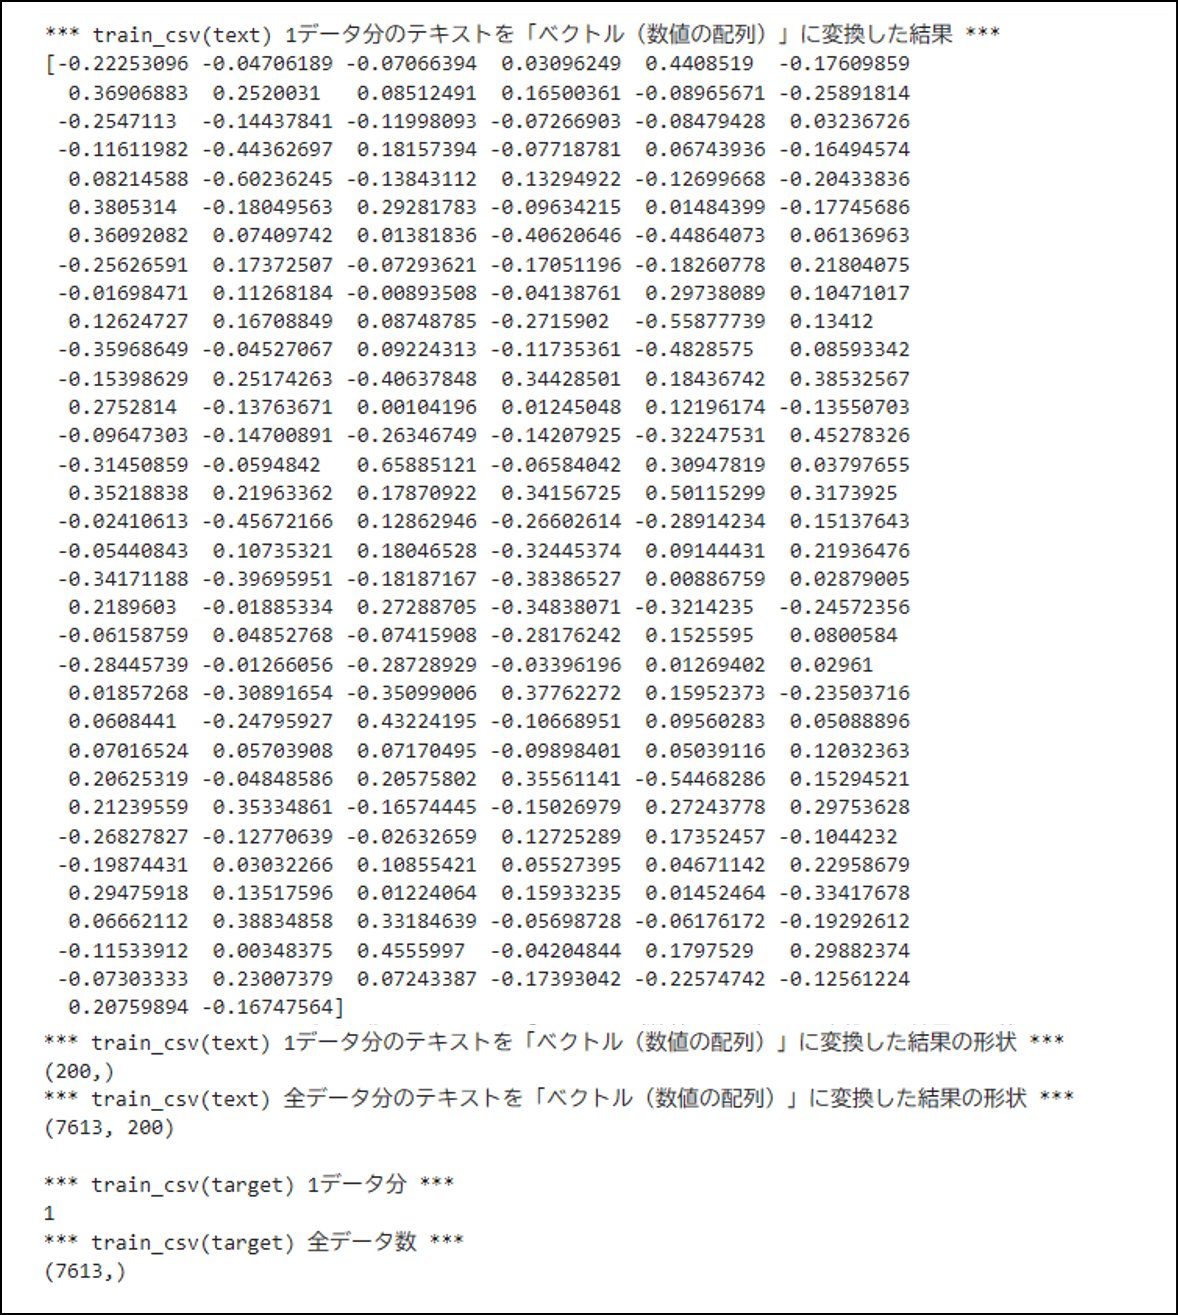
モデル作成と評価
「Natural Language Processing with Disaster Tweets」コンペで、先述の前処理後の、モデル作成・評価の実装例は、以下の通り。
1) 前処理後の訓練データ(train.csv)を訓練データとテストデータに分割する。
from sklearn.model_selection import train_test_split

# 訓練データ(train.csv)を訓練用とテスト用に分割する
# random_state : 実行結果を毎回固定するために指定
# stratify : 均等に分割したいデータ
# test_size : テスト用に利用したい割合
train_data, test_data, train_label, test_label = train_test_split(X_train_w2v, y_train, random_state=0, stratify=y_train, test_size=0.3)
print("train_data_shape : " + str(train_data.shape))
print("test_data_shape : " + str(test_data.shape))
print("train_label_shape : " + str(train_label.shape))
print("test_label_shape : " + str(test_label.shape))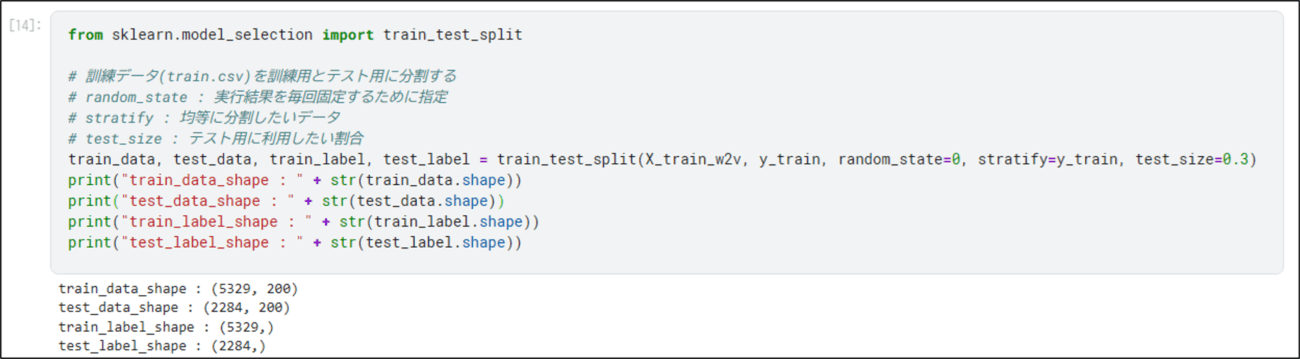
2) 機械学習モデル(下記ではロジスティックス回帰)を作成し学習する。
from sklearn.linear_model import LogisticRegression

# ロジスティックス回帰で学習する
clf = LogisticRegression(random_state=0)
clf.fit(train_data, train_label)
3) 2)で作成した機械学習モデルを評価する。
from sklearn import metrics

# テストデータで正解率を評価する
y_pre = clf.predict(test_data)
ac_score = metrics.accuracy_score(test_label, y_pre)
print('正解率{0:.1f}%'.format(ac_score * 100))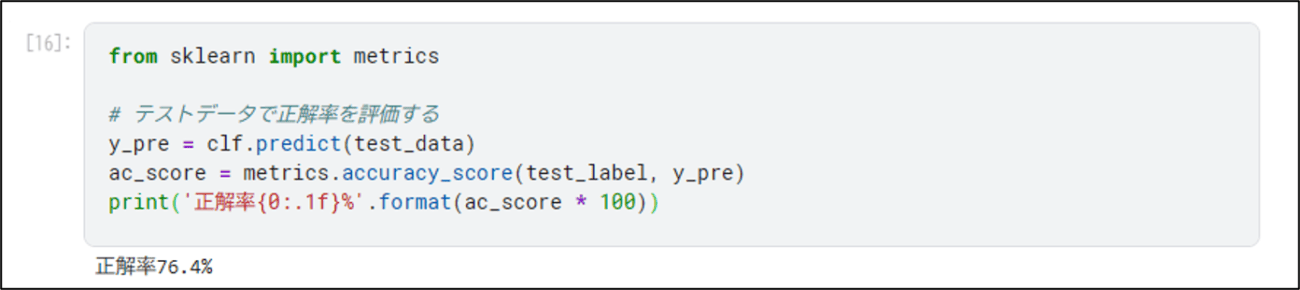
Word2Vecでベクトル化したデータの可視化
「Natural Language Processing with Disaster Tweets」コンペで、Word2Vecでベクトル化したデータを可視化するには、主成分分析(PCA)で次元削減するとよい。その実装例は、以下の通り。
1) 主成分分析(PCA)で次元削減し、寄与率が高い「ベクトル(数値の配列)」を表示する。
from sklearn.decomposition import PCA
import matplotlib.pyplot as plt

# PCAによる20次元への次元削減
pca = PCA(n_components=20, random_state=0)
vectors_10d = pca.fit_transform(X_train_w2v)

# 寄与率の確認
np.set_printoptions(precision=5, suppress=True) # numpyの小数点以下表示桁数と、指数表記設定
print('上位20次元までの寄与率: {}'.format(pca.explained_variance_ratio_))

# 寄与率をグラフ描画して確認
plt.bar([n for n in range(1, len(pca.explained_variance_ratio_)+1)], pca.explained_variance_ratio_)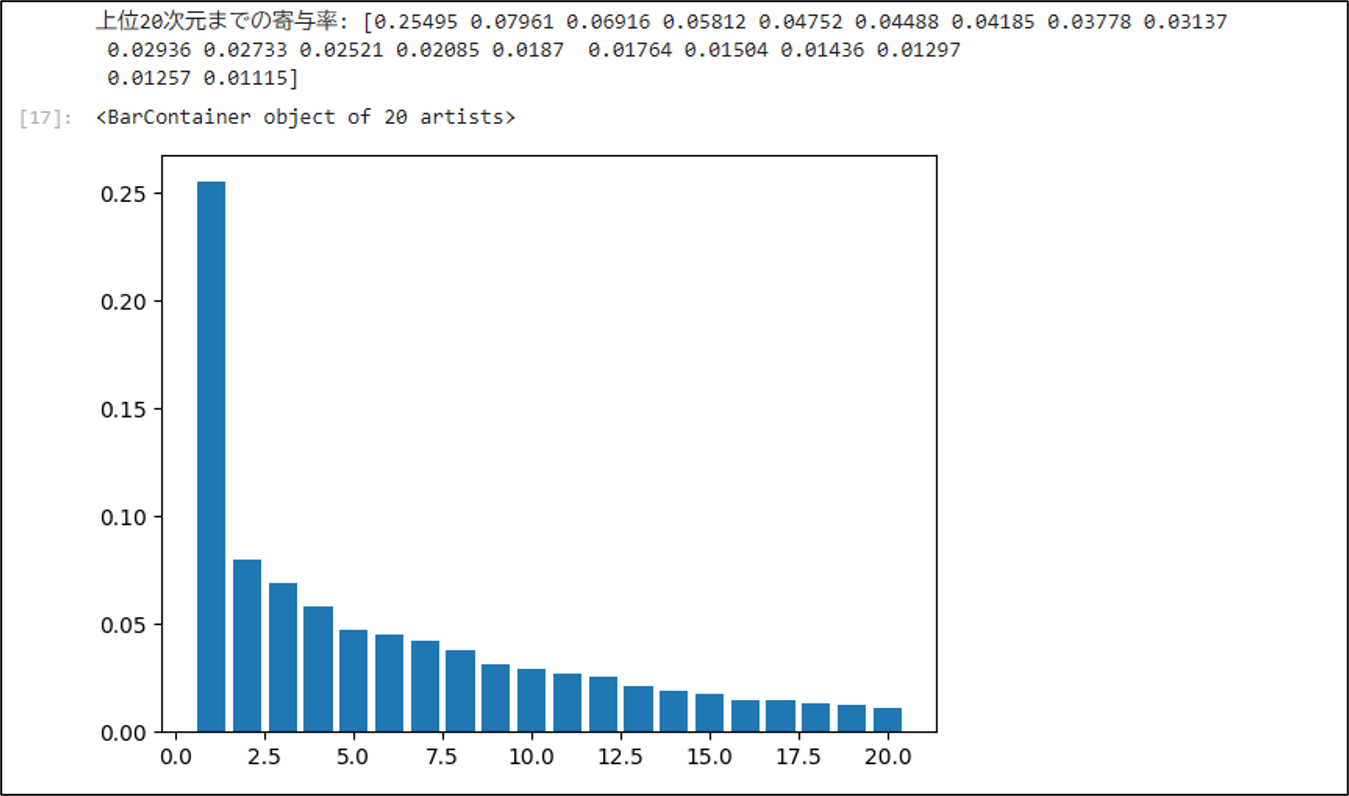
なお、主成分分析(PCA)や寄与率については、以下のサイトを参照のこと。
https://qiita.com/oki_kosuke/items/70c7e0bcd7b534589f69
2) 主成分分析(PCA)で2次元に次元削減した結果をグラフ描画する。
from sklearn.decomposition import PCA
import matplotlib.pyplot as plt

# PCAによる2次元への次元削減
pca = PCA(n_components=2, random_state=1)
vectors_2d = pca.fit_transform(X_train_w2v)

# PCAの上位2次元と正解値を散布図にプロット
plt.figure(figsize=(10, 8))
plt.rcParams["font.family"] = "sans-serif"

# y_trainをnumpy配列に変換(インデックス指定によるフィルタリングのため)
y_train_arr = np.array(y_train)

# Target: 0 (緑) のプロット
mask_0 = (y_train_arr == 0)
plt.scatter(vectors_2d[mask_0, 0], vectors_2d[mask_0, 1], c='g', edgecolor='k', label='Target:0')

# Target: 1 (青) のプロット
mask_1 = (y_train_arr == 1)
plt.scatter(vectors_2d[mask_1, 0], vectors_2d[mask_1, 1], c='b', edgecolor='k', label='Target:1')

# 凡例・タイトルを表示
plt.legend()
plt.title("Word2Vec PCA Scatter Plot")
plt.grid(True)
plt.show()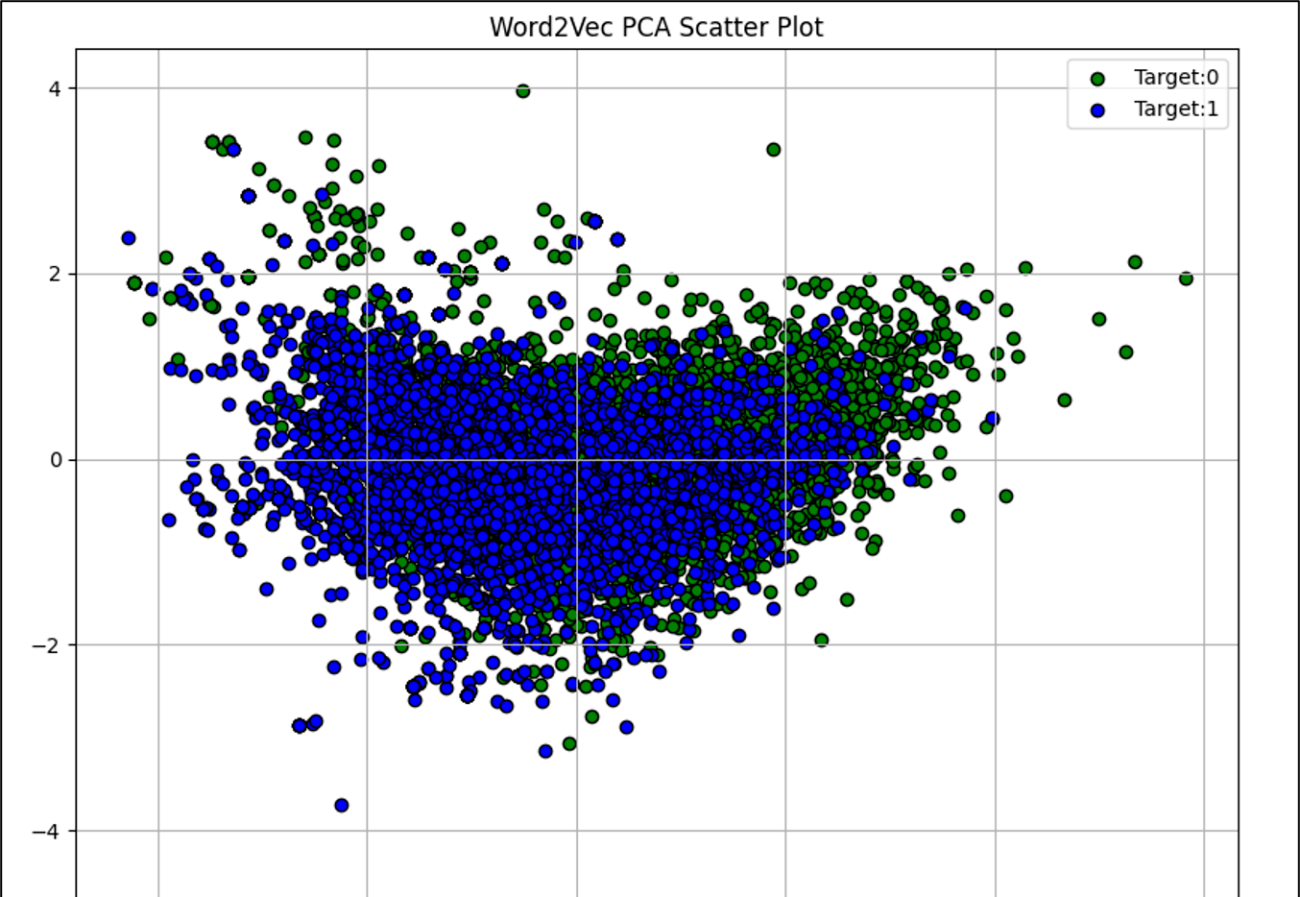
テストデータの予測結果の算出と提出
「Natural Language Processing with Disaster Tweets」コンペで、テストデータの予測結果を算出し、Kaggleで予測結果を提出する実装例は、以下の通り。
1) 前処理後のテストデータ(test.csv)のテキストデータ(text)を、ベクトル(数値の配列)に変換する。
# テストデータ(test.csv)の全データ分のテキストを「ベクトル(数値の配列)」に変換する
X_test_w2v = np.vstack([tweet_to_vector(text, w2v_model) for text in test_csv['clean_text']])
print("*** test_csv(text) 1データ分のテキストを「ベクトル(数値の配列)」に変換した結果 ***")
print(X_test_w2v[0])
print("*** test_csv(text) 1データ分のテキストを「ベクトル(数値の配列)」に変換した結果の形状 ***")
print(X_test_w2v[0].shape)
print("*** test_csv(text) 全データ分のテキストを「ベクトル(数値の配列)」に変換した結果の形状 ***")
print(X_test_w2v.shape)
print()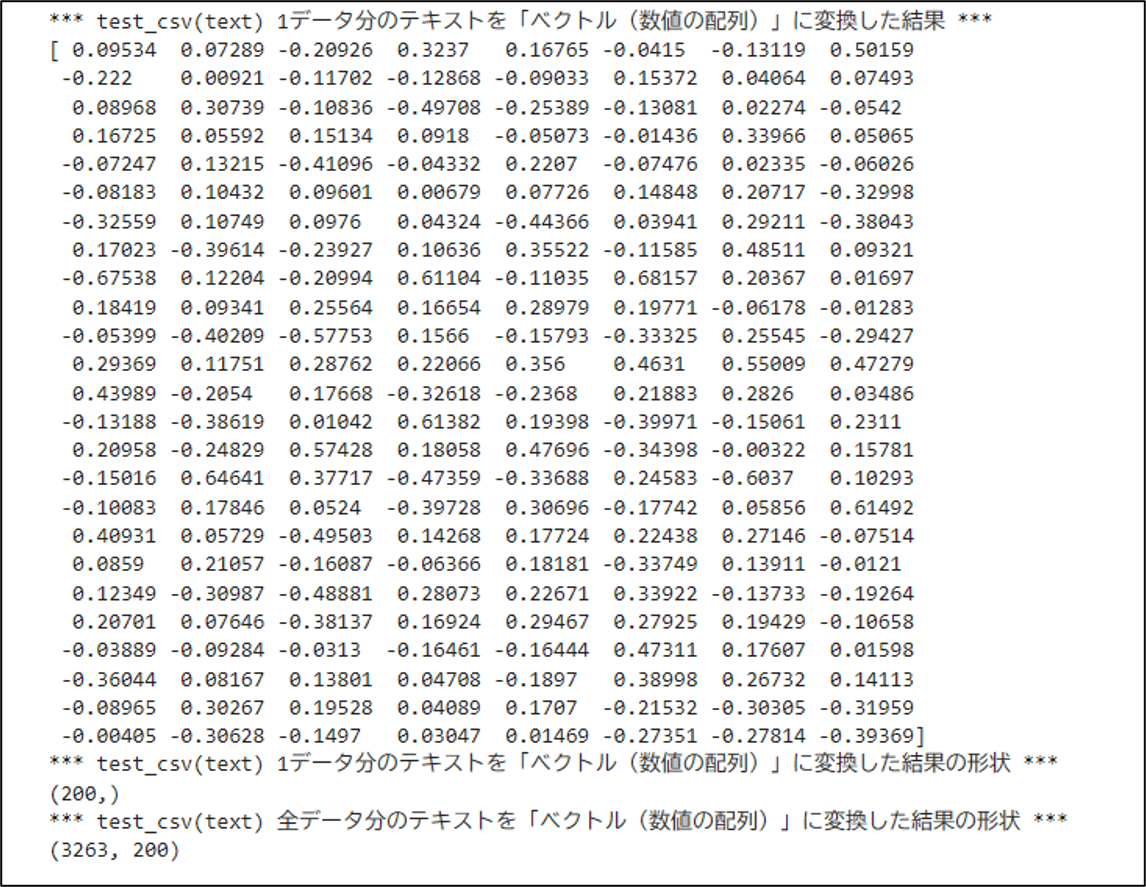
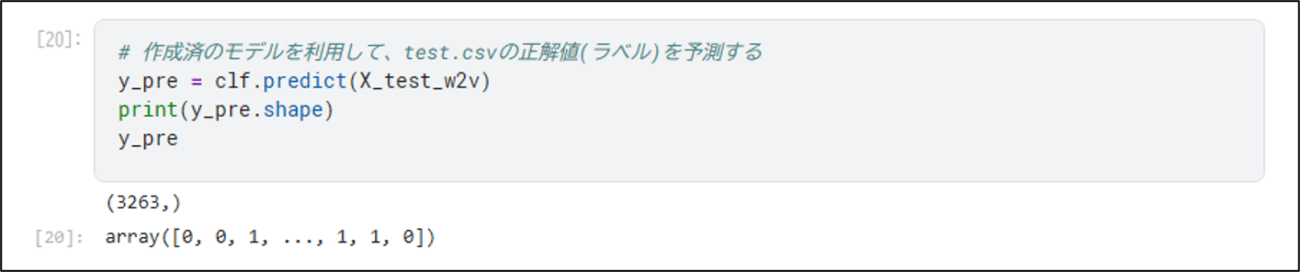
2) 作成済の機械学習モデルを用いて、test.csvの正解値(ラベル)を予測する。
# 作成済のモデルを利用して、test.csvの正解値(ラベル)を予測する
y_pre = clf.predict(X_test_w2v)
print(y_pre.shape)
y_pre
3) インプットファイルのうち、Kaggle提出用ファイルフォーマット「sample_submission.csv」を読み込む。
# sample_submission.csvを読み込む
sample_submission = pd.read_csv('/kaggle/input/competitions/nlp-getting-started/sample_submission.csv', header=0, encoding='UTF-8')
print(sample_submission.shape)
sample_submission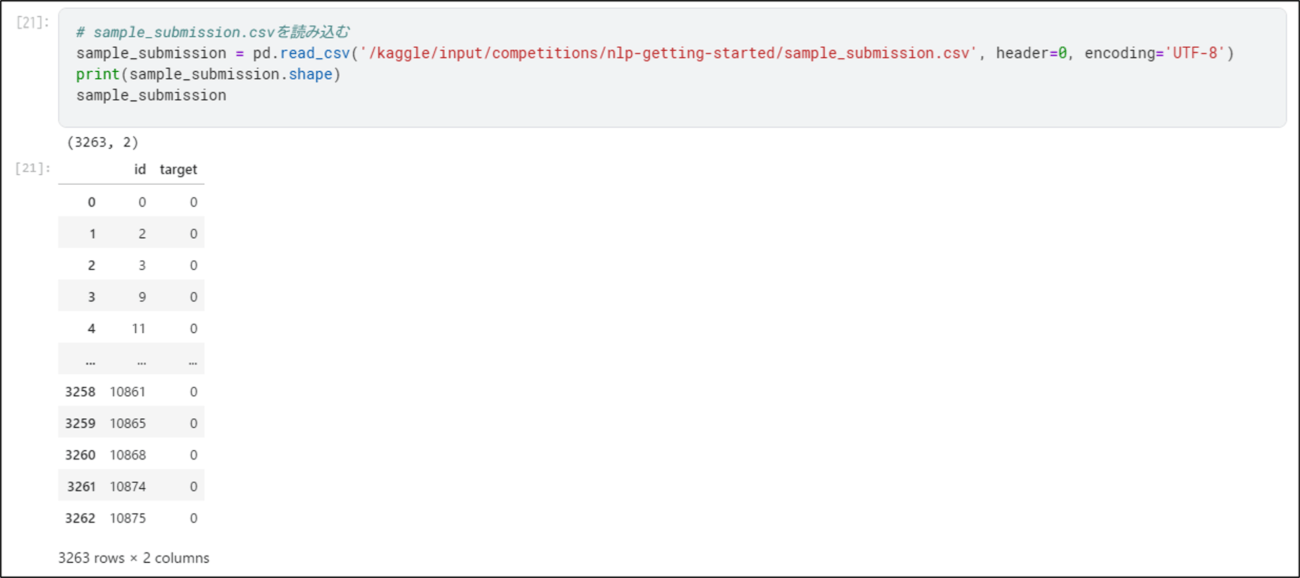
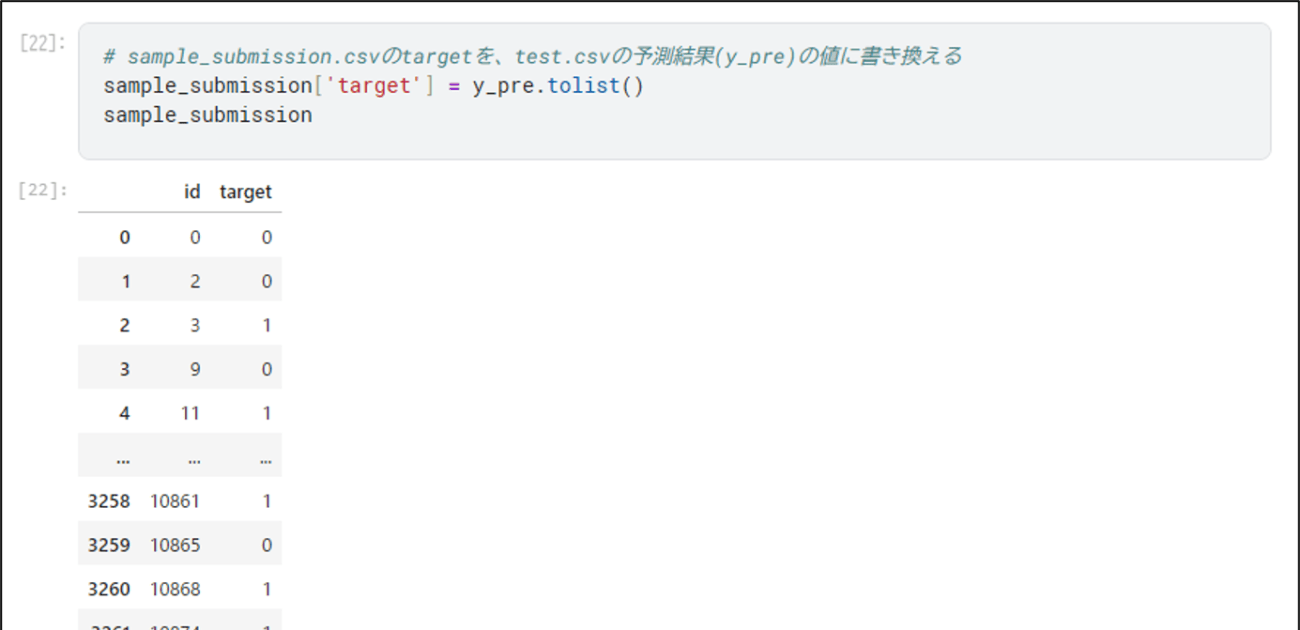
4) test.csvの予測結果を、Kaggle提出用ファイルに書き出す。
# sample_submission.csvのtargetを、test.csvの予測結果(y_pre)の値に書き換える
sample_submission['target'] = y_pre.tolist()
sample_submission
# 予測結果をCSVファイル(submission.csv)に書き出す
# index=Falseを指定しないと不要な行番号が書き込まれてエラーになる
sample_submission.to_csv('submission.csv', index=False)
# 書き出したCSVファイル(submission.csv)を読み込んで確認する
submission = pd.read_csv('/kaggle/working/submission.csv', header=0, encoding='UTF-8')
print(submission.shape)
submission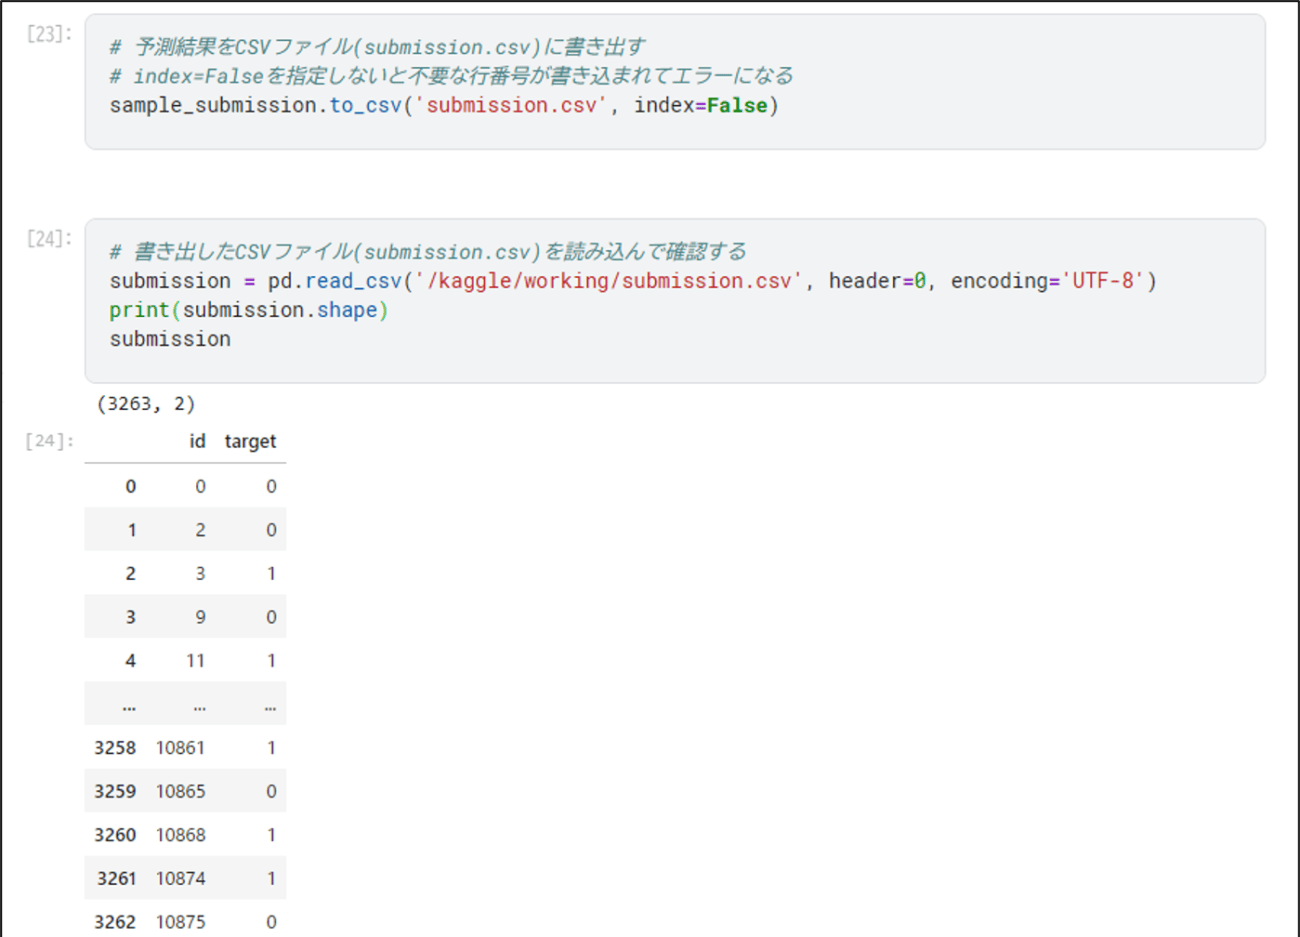
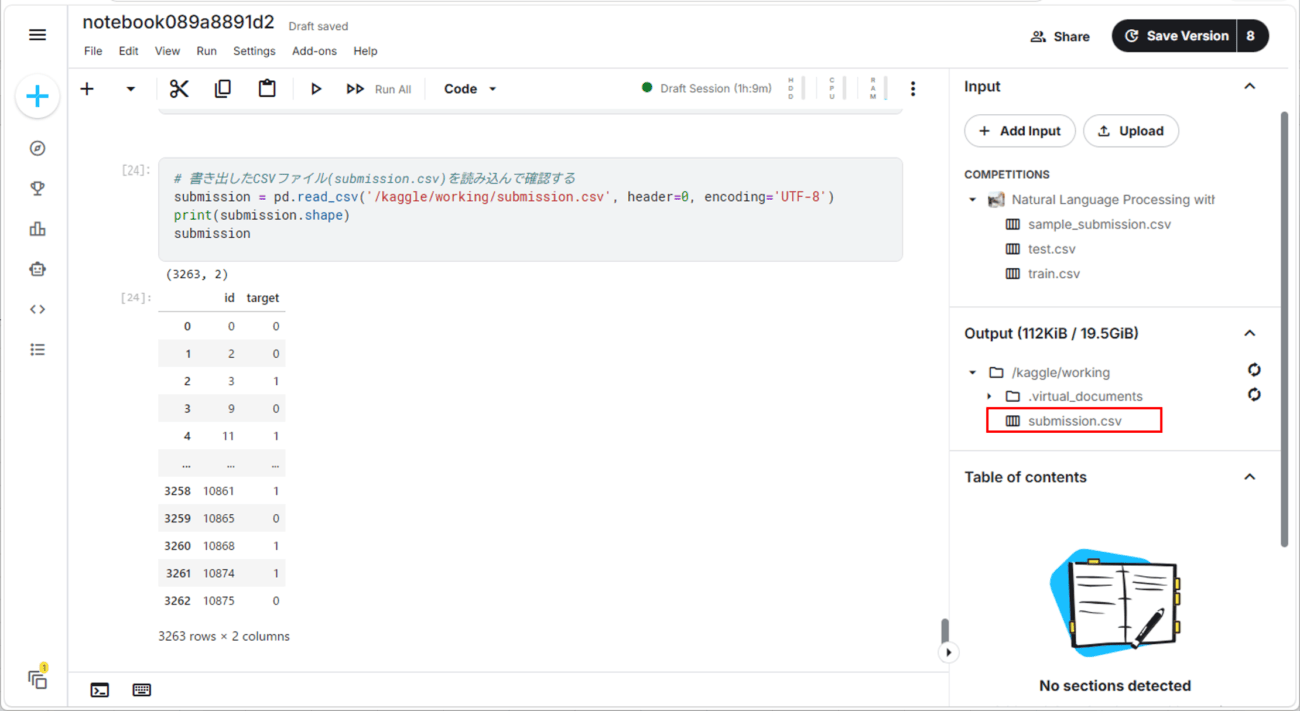
5) Kaggle提出用ファイルとして、下記赤枠の「submission.csv」が出力されていることを確認する。
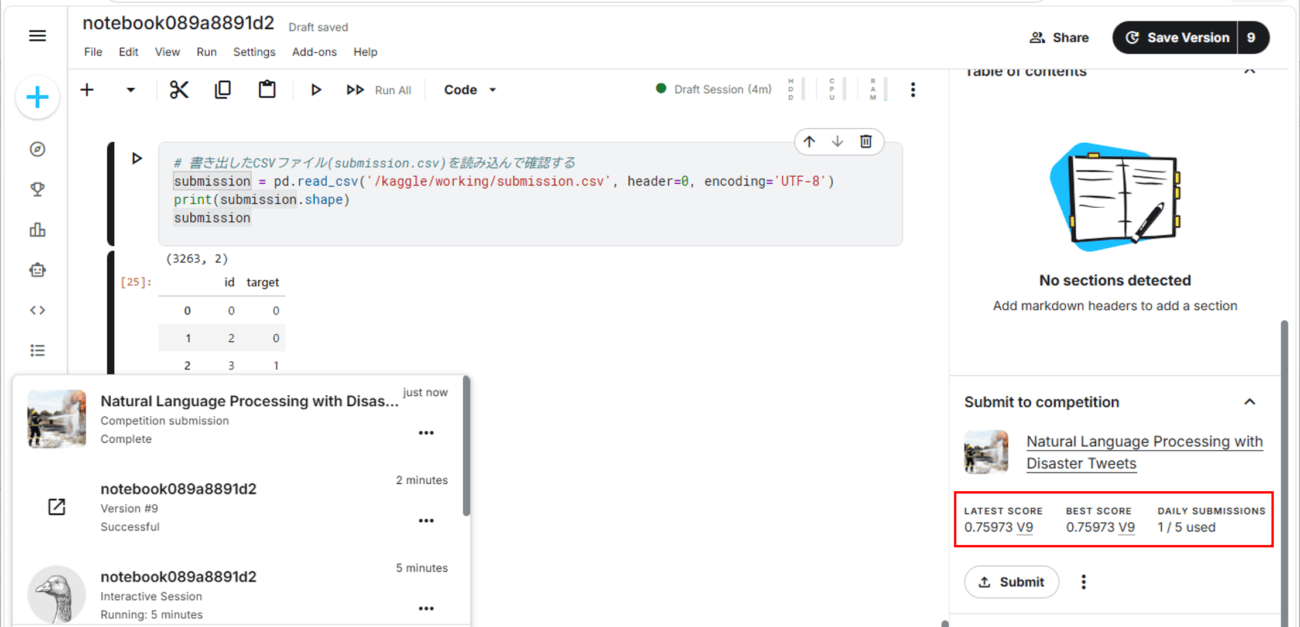
6) Kaggleに予測結果を提出した結果、以下のように表示される。
なお、Kaggleでの予測結果提出方法は、以下のサイトの「Kaggleでのファイル保存と提出」を参照のこと。
要点まとめ
- 自然言語を機械学習モデルで利用するには、自然言語を数値で表現できる必要があり、その手法の1つにWord2Vecがある。
- Word2Vecでベクトル化したデータは、主成分分析(PCA)で2次元に次元削減すると、グラフ描画できる。